Du kan ikke ansætte dig ud af en stigende mængde henvendelser, og du kan ikke blive ved med at triagere hurtigere. Et PSIRT skalerer ved at besvare de fleste "er vi berørt?"-spørgsmål ud fra data, det registrerede, da hver version blev bygget, og ved at offentliggøre svaret, før kunderne spørger. Det dyre trin i dag er at spørge engineering, hvad et produkt indeholder. Flyt det trin til build-tidspunktet, så bliver de fleste henvendelser til opslag, som support kan lukke.
Dette indlæg forudsætter, at du allerede driver et PSIRT; hvis du er ved at oprette et, så start med hvad et PSIRT er, og hvordan du bygger et. Nedenfor: hvorfor mængden har ændret sig, hvor tiden går i den sædvanlige pipeline, og hvad du skal ændre, i rækkefølge.
Hvorfor mængden har ændret sig
Stigningen er strukturel, ikke et dårligt kvartal. Fire ting presser på den samme kø på én gang.
Flere CVE'er. CVE-programmet offentliggjorde 39.718 CVE-poster i 2024 og 47.801 i 2025. I 2026 passerede antallet hele 2025's årstotal længe før årets udgang; vores live CVE-publiceringstendenser følger det dag for dag. FIRST's opdaterede sårbarhedsprognose for 2026 (15. juni 2026) hævede sit skøn for året til omkring 66.000 CVE'er og sagde ligeud, hvad årsagen er: AI kan finde betydeligt flere fejl end menneskelige analytikere, og "begrænsningen er ikke længere at opdage dem; det er den menneskelige kapacitet til at verificere, koordinere og patche". Et PSIRT er den menneskelige kapacitet.
Kunderne scanner dit produkt. Kunder kører scannere mod dine images, din firmware og dine appliances og videresender hvert fund som en ticket. De fleste af de fund er scannerstøj om komponenter, du ikke leverer, eller versioner, der ikke er berørt, og støjen bliver dit indtag. At reducere sårbarhedsstøj dækker scannersiden.
Regulering giver deadlines. Siden 11. september 2026 har rapporteringsforpligtelserne i EU's Cyber Resilience Act været gældende. En aktivt udnyttet sårbarhed i et produkt, der sælges i EU, kræver en tidlig advarsel inden for 24 timer efter, at producenten er blevet opmærksom på den.
Mindre hjælp fra NVD. Den 15. april 2026 lagde NIST National Vulnerability Database om til risikobaseret berigelse: CVE'er i CISA's KEV-katalog, software, som den føderale regering bruger, og kritisk software efter EO 14028 kommer først, og resten markeres "Lowest Priority - not scheduled for immediate enrichment". Færre CVE'er kommer med CPE-data, så matchning på produktnavn bliver dårligere, netop som mængden stiger.
| Drivkraft | Hvad den gør ved PSIRT'ets kø |
|---|---|
| CVE-mængde, AI-assisteret opdagelse | Flere tredjeparts-CVE'er at vurdere pr. produkt, hver måned |
| Kunders scanning | Flere henvendelser pr. CVE, mange om komponenter, du ikke leverer |
| CRA-rapportering | En 24-timers deadline for aktivt udnyttede sårbarheder |
| Mindre NVD-berigelse | Mere manuelt arbejde for at koble en CVE til de produkter, den rammer |
Hvor tiden går: henvendelsespipelinen, som den typisk kører
Vi hører om den samme pipeline fra produktsikkerhedsteams igen og igen. Et PSIRT på to personer hos en hardwareleverandør beskrev den sådan for os: En kunde spørger supportdesken, support sender spørgsmålet videre til PSIRT'et via CRM'et, sagen lander i PSIRT'ets tracker, PSIRT'et undersøger de produkter, kunderne spørger mest om, og giver derefter spørgsmålet videre til engineering og venter.
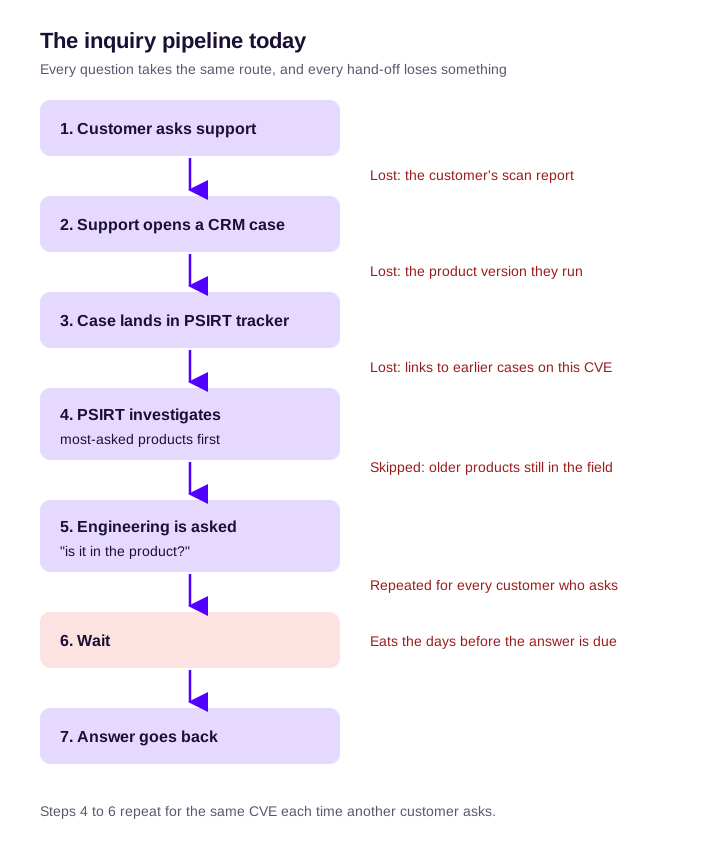
Tag en enkelt illustrativ henvendelse. En kunde videresender en scannerrapport, der lister 40 CVE'er mod firmwareversion X. Support opretter en sag og vedhæfter rapporten, men ikke det præcise build, kunden kører. PSIRT'et tjekker, hvilke af de 40 det allerede har vurderet, finder et dusin, det ikke har, og spørger det engineering-team, der ejer produktet, om komponenterne er i version X. Engineering skal finde kildekoden til version X, regne ud, hvilke afhængighedsversioner der kom med i den, og svare. Tallene er opdigtede; mønsteret er det ikke.
Selve analysen er sjældent det, der tager tid. To skjulte omkostninger er:
- Den samme CVE undersøges igen for hver kunde, der spørger. Når svaret ligger i en mailtråd, starter den næste kunde undersøgelsen forfra.
- "De mest efterspurgte produkter først" efterlader den lange hale ubesvaret. Ældre produkter, der stadig er i brug, bliver aldrig tjekket, og det er ofte der, risikoen er: ældre komponenter, færre opdateringer, færre folk, der husker, hvordan de blev bygget.
Indtag: adskil spørgsmål fra rapporter
En forskers sårbarhedsrapport og en kundes "er vi berørt?" er forskelligt arbejde, og de har brug for forskellige veje. FIRST PSIRT Services Framework forventer allerede rodet input: Et PSIRT bør "forvente at modtage sårbarheder gennem forskellige kanaler og i varierende kvalitet" (underfunktion 2.1.1.1). Dets serviceområde for triage går videre: "Hvor organisationer modtager en stor mængde sårbarhedsrapporter, kan de overveje at foretage en indledende triage for at validere rapporter, før der oprettes sager." Tag det som en tilladelse til ikke at åbne en PSIRT-sag for hver henvendelse.
Del henvendelserne op ved supportdesken i tre veje:
| Kunden spørger om | Vej | Hvem svarer |
|---|---|---|
| En offentliggjort CVE i en tredjepartskomponent, du allerede har vurderet | Svar ud fra den offentliggjorte VEX-erklæring eller advisory; ingen PSIRT-sag | Support |
| En offentliggjort CVE, du endnu ikke har vurderet | Én PSIRT-sag pr. CVE, ikke pr. kunde; knyt hver henvendelse til den | PSIRT, derefter svarer support alle de tilknyttede |
| En ny sårbarhed i din egen kode | En sårbarhedsrapport: hele processen for koordineret offentliggørelse af sårbarheder | PSIRT |
Support skal bruge to ting for at kunne arbejde med den første vej: en søgbar liste over vurderede CVE'er pr. produkt og version og svarskabeloner. Sådan svarer du kunder efter et forsyningskædeangreb har skabeloner, du kan tilpasse.
Registrér produktet og den præcise version, kunden kører, ved indtaget. Uden versionen er hvert svar "det kommer an på", og sagen kommer tilbage.
Prioritér efter eksponering, ikke kun popularitet
"De mest efterspurgte produkter først" er en rimelig tommelfingerregel. Den har brug for en akse mere. Behold populariteten (installeret base, omsætning, hvor ofte support spørger), og tilføj eksponering: Er produktet stadig understøttet, vender det mod internettet i typiske installationer, og er CVE'en i CISA's KEV-katalog eller højt på EPSS? Guiden til prioritering af sårbarheder dækker signalerne i dybden.
| Lav eksponering | Høj eksponering | |
|---|---|---|
| Stor installeret base | Svar ud fra oversigten; offentliggør VEX for ikke-berørte versioner | Undersøg først; advisory og rettelse med den korteste frist |
| Lille installeret base | Svar ud fra oversigten på forespørgsel; intet proaktivt arbejde | Spring den ikke over: svar ud fra oversigten, og beslut derefter en rettelse eller en afhjælpningsmeddelelse |
Pointen med matrixen er venstre kolonne og nederste række. Den lange hale får et svar ud fra data, ikke ud fra en undersøgelse, ingen har tid til.
Under CRA afgør den supportperiode, du har angivet for hvert produkt, hvilke ældre produkter du stadig skylder svar og sikkerhedsopdateringer for (hvad CRA kræver).
Overdragelsen til engineering er flaskehalsen
Dette afsnit er til den engineering-leder, der modtager PSIRT'ets eskaleringer.
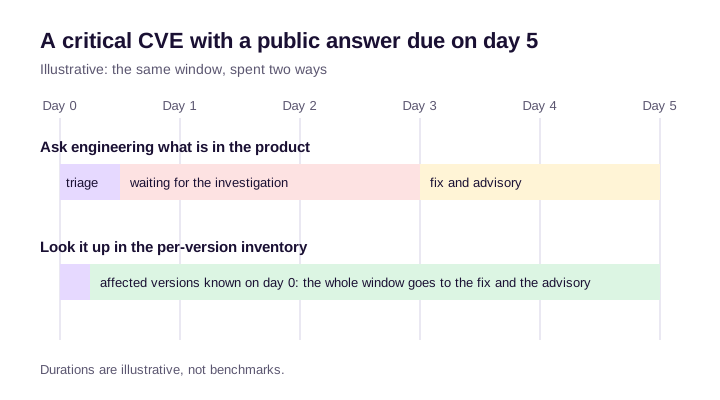
PSIRT'ets deadlines er offentlige: En kunde, en myndighed eller en offentliggørelsesdato venter. Engineerings deadlines er det som regel ikke, så PSIRT'et opsuger forskellen. Et kritisk problem, der overdrages en mandag uden svar tirsdag, efterlader to dage, før det offentlige svar skal ud.
PSIRT'et sender engineering to forskellige spørgsmål, og kun det ene af dem burde kræve engineering:
- "Er komponenten i produktet?" er et dataspørgsmål. Det bør besvares ud fra en registrering, ikke af en person, der læser build-filer.
- "Kan I rette det inden dato X?" er et arbejdsspørgsmål. Det hører til hos engineering.
FIRST-rammeværket siger, hvordan det første spørgsmål kan tages af engineerings bord. Funktion 2.3.5 beder PSIRT'er om at "etablere automatiserede kanaler, der distribuerer identificerede sårbarhedsmeddelelser fra tredjeparter direkte til udviklingsteamene for de berørte produkter", så tredjeparts-advisories behandles i udviklingsprocessen, og PSIRT'et håndterer færre af dem manuelt.
Aftal tre ting med engineering:
- En ejer pr. produkt. Hos store leverandører er afhjælpningen fordelt på produktteams; rammeværkets distribuerede model findes, fordi den lader PSIRT-missionen skalere gennem de udviklere, der ejer produkterne.
- Responsmål pr. alvorlighed, skrevet ned, for rettelsen og ikke for undersøgelsen.
- Hvad der sker, når et mål ikke nås. Funktion 4.2.4 beder om "en proces for formel risikoaccept for alle sårbarheder, der ikke er afhjulpet inden for de tidskrav, der er fastsat i de interne SLA'er". En person med beføjelse skriver under på risikoen; den bliver ikke bare stående åben.
Rettelsestakten varierer. Ét team leverer en patch natten over, et andet har brug for en platformopgradering på seks måneder. Advisoryen skal sige hvilken, så kunderne kan planlægge.
Gør "er vi berørt?" til et opslag: en SBOM for hver leveret version
Det er den ændring, der fjerner mest arbejde. FIRST-funktion 2.3.1, oversigten over produktkomponenter, kalder den "afgørende for hurtigt at identificere berørte produkter for nedarvede sårbarheder". PSIRT-modenhedsniveauerne placerer et produktregister med afhængighedskortlægning på mellemniveauet og overvågning af sårbarheder i produktkomponenter på det avancerede niveau.
En oversigt fjerner kun arbejde, hvis den holder under pres. Hvert krav nedenfor er der af en grund:
- Én SBOM pr. leveret version, ikke pr. repository og ikke af default-branchen. Kunder kører versioner, ikke branches.
- Taget fra det build, der producerede releasen. Et senere genbuild eller en scanning af dagens repository beskriver anden software (SBOM'er fra build-tidspunktet).
- Transitive og skjulte afhængigheder med. Den sårbare pakke er sjældent en, du selv har tilføjet (transitive afhængigheder), og installationsscripts, base-images og gendannede caches bringer komponenter ind, som ingen lockfile lister.
- Et signal om fuldstændighed. En delvis registrering, der behandles som en fuld, giver sikre "ikke berørt"-svar, der er forkerte.
- Gemt, så længe versionen er understøttet. Registreringen for en version fra for tre år siden er den, du får brug for, når ingen længere husker, hvordan den blev bygget.
- Leverandør-SBOM'er for indkøbte komponenter, så tredjepartssoftware er i den samme oversigt som din egen.
- Matchet løbende igen, efterhånden som nye CVE'er offentliggøres, i stedet for at blive scannet igen, når nogen spørger.
Et gennemgået eksempel. En ny CVE offentliggøres i et udbredt komprimeringsbibliotek. Uden oversigten spørger PSIRT'et hvert produktteam, svarene drypper ind over flere dage, og de ældste produkter bliver aldrig tjekket. Med den returnerer én forespørgsel de berørte produkter og versioner plus det første og det sidste build, der indeholdt den sårbare version. Det er det eksponeringsvindue, kunderne spørger om bagefter; er vi berørt af en CVE? viser, hvordan du fastlægger det i et enkelt tilfælde.
Embedded- og Yocto-porteføljer har det sværest. Scannere, der læser et færdigt firmware-image, må gætte, hvad der blev kompileret ind i det, og teams, vi taler med, har oplevet, at scanner-proof-of-concepts slog fejl på Yocto-baserede produkter. At registrere buildet, mens det kører, undgår gætteriet (Yocto-builds på CRACI).
Når en kunde derefter beder om selve SBOM'en i et bestemt format, så se at besvare kunders SBOM-forespørgsler.
Outputsiden: advisories og VEX, der svarer, før nogen spørger
Den billigste henvendelse er den, der aldrig kommer.
- Offentliggør "not affected" som VEX, så kundernes scannere holder op med at markere CVE'en, og offentliggør "affected" og "fixed" som advisories med præcise versioner.
- Gør det maskinlæsbart. FIRST-underfunktion 5.3.2.3 foreslår, at PSIRT'er "overvejer at offentliggøre advisories i et maskinlæsbart format som Common Security Advisory Framework (CSAF)", så kunderne kan bruge dem med deres egne værktøjer. CSAF-guiden dækker, hvordan du går fra websider og RSS-feeds til CSAF.
- Orientér support, før du offentliggør. Funktion 5.3.4: "At give forudgående, fortrolig besked og en FAQ om kommende advisories forbereder dem, der kan blive spurgt om dem, når de offentliggøres." Så kan support svare samme dag.
- Send ud, læg ikke bare op. Underfunktion 5.4.1.3 bemærker, at få sidevisninger på advisories "kan føre din strategi i retning af proaktiv underretning". Feeds og notifikationer når de kunder, der aldrig besøger en advisory-side.
CRA gør en del af dette til en pligt. Artikel 14(8) kræver, at producenten, efter at være blevet opmærksom på en aktivt udnyttet sårbarhed eller en alvorlig hændelse, underretter de berørte brugere "og, hvor det er relevant, alle brugere", og gør det "hvor det er relevant, i et struktureret, maskinlæsbart format, der let kan behandles automatisk". Forordningen nævner ikke et bestemt format.
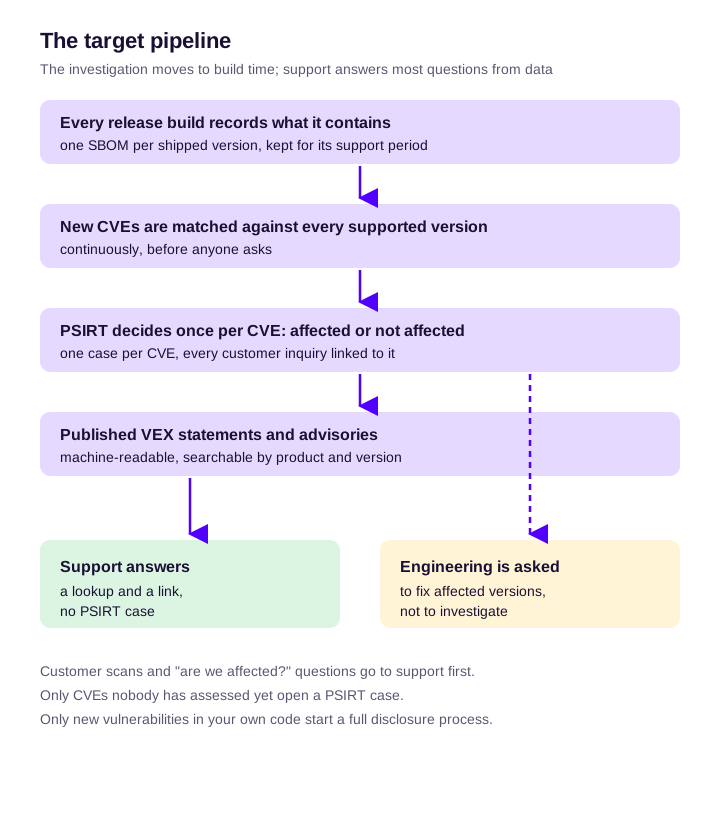
Hvad du skal automatisere, i rækkefølge
Hvert trin fjerner en slags arbejde; metrikken viser, om det lykkedes.
| Trin | Arbejde, det fjerner | Metrik, der viser, at det virkede |
|---|---|---|
| 1. En oversigt pr. version fra buildet | Spørgsmålet "hvad er der i det?" til engineering | Antallet af undersøgelsesanmodninger til engineering pr. måned falder |
| 2. Løbende matchning af nye CVE'er mod hver understøttet version | Ny scanning på forespørgsel | Tid fra CVE-offentliggørelse til en beslutning om berørt eller ikke berørt |
| 3. Én sag pr. CVE med henvendelserne tilknyttet | Dobbelte undersøgelser | Henvendelser pr. sag stiger, sager pr. CVE forbliver én |
| 4. Automatisk routing af berørte fund til det ejende team (FIRST 2.3.5) | Manuelle overdragelser | Tid fra beslutning til en ejer, der kvitterer for den |
| 5. Et søgbart bibliotek af offentliggjorte VEX-erklæringer og advisories | PSIRT'ets involvering i gentagne spørgsmål | Andelen af henvendelser, som support lukker |
| 6. Maskinlæsbar offentliggørelse (CSAF) | Kunder, der spørger om det, deres værktøjer kunne have hentet | Henvendelser pr. offentliggjort advisory falder |
| 7. AI-assistance til udkast til advisories og svar | Skrivetid | Tid fra beslutning til offentliggjort advisory |
AI kommer sidst af en grund. Den skriver gode udkast oven på registrerede data, og den bør aldrig være kilden til beslutningen om "berørt".
Nogle ting bør ikke automatiseres: vurderingen af "ikke berørt" og fastsættelsen af alvorlighed bliver hos en person, med dokumentationen vedhæftet. Automatiseringen afgør, hvor hurtigt den person får dokumentationen.
Metrikker, der viser, at PSIRT'et skalerer
- Andelen af henvendelser, der besvares uden en PSIRT-sag.
- Tid fra CVE-offentliggørelse til en beslutning om berørt eller ikke berørt, pr. produkt.
- Undersøgelsesanmodninger til engineering pr. måned. Tallet bør falde.
- Andelen af rettelser til tiden pr. alvorlighed; rammeværkets underfunktion 4.4.2.4 definerer den som, hvor godt produktteams overholder den aftalte tid fra rapport til rettelse.
- VEX- og advisory-dækning af de versioner, du stadig understøtter.
Vi angiver ikke branchebenchmarks for disse. Ingen primærkilde, vi stoler på, offentliggør et.
Hvor CRACI passer ind
CRACI dækker trin 1 og 2 og dele af trin 4 og 5 for software, der bygges i GitHub Actions. Dine builds kører på CRACI's runners, og CRACI registrerer, hvad hvert job faktisk trak ind, mens det kørte: direkte og transitive afhængigheder, pakker installeret af scripts og pakker gendannet fra CI-caches. Hvert jobs SBOM har en fuldstændighedsstatus, så en delvis registrering aldrig forveksles med en fuld.
CRACI gemmer build-historikken, så når en ny CVE offentliggøres, ser du, hvilke builds der indeholdt den sårbare afhængighed, og siden hvornår, så langt tilbage som din opbevaringsperiode rækker. Overvågede SBOM'er vurderes løbende igen, fund samles på tværs af builds og repositories, og leverandør-SBOM'er kan tilføjes, så indkøbte komponenter overvåges sammen med dine egne builds. CRACI giver de relevante personer besked om en ny sårbarhed og dens alvorlighed. Inventarvisningen viser, hvilke softwareversioner der er udrullet til hvilke produkter, og sikkerhedsteams triagerer hvert fund i CRACI og sender det til det team, der ejer rettelsen. CRACI understøtter VEX. Se CRACI til PSIRT'er og sårbarhedssporing.
Se, hvilke af dine leverede versioner der indeholder en CVE.
Når CRACI ikke er svaret
- Din flaskehals er indtag og sagsstyring, delen fra CRM til tracker. CRACI er ikke et værktøj til sagsstyring eller offentliggørelse af advisories; til den halvdel har du brug for et sagsværktøj (PSIRT-værktøjer sammenlignet).
- Dine produkter bygges ikke i GitHub Actions på Linux-runners. GitHub Actions er den understøttede CI i dag; GitLab CI og Jenkins er på roadmappen, uden dato.
- Du har brug for binær- eller firmwareanalyse af produkter, du ikke selv har bygget. Det er, hvad værktøjer til outputanalyse gør (sikkerhedsværktøjer til embedded sammenlignet).
- Du har brug for reachability-analyse for at argumentere for "ikke berørt". Det tilbyder CRACI ikke.
Ofte stillede spørgsmål
Hvordan skalerer man et PSIRT uden at ansætte?
Hold op med at undersøge det samme spørgsmål igen og igen. Registrér, hvad hver leveret version indeholder, når den bygges, match nye CVE'er mod den løbende, beslut én gang pr. CVE, og offentliggør beslutningen som VEX eller en advisory, som support kan henvise til. Så arbejder PSIRT'et med de sager, der reelt er åbne, og engineering bliver bedt om at rette, ikke om at undersøge.
Hvordan bør et PSIRT håndtere kunders "er vi berørt?"-henvendelser?
Behandl dem som en separat indtagsstrøm adskilt fra sårbarhedsrapporter. Support besvarer spørgsmål om CVE'er, du allerede har vurderet, ud fra offentliggjort materiale. En CVE, du endnu ikke har vurderet, får én PSIRT-sag, som hver kundehenvendelse knyttes til. Kun en ny sårbarhed i din egen kode går gennem hele offentliggørelsesprocessen.
Hvad siger FIRST PSIRT Services Framework om mængde og automatisering?
Det forventer rapporter "gennem forskellige kanaler og i varierende kvalitet", tillader triage, før der oprettes sager, når mængden er stor, kalder en oversigt over produktkomponenter "afgørende for hurtigt at identificere berørte produkter" og beder om automatiserede kanaler, der sender sårbarhedsmeddelelser fra tredjeparter direkte til udviklingsteamene for de berørte produkter (funktion 2.3.5).
Hvad bør et PSIRT automatisere først?
Oversigten pr. version taget fra buildet og derefter løbende matchning af nye CVE'er mod hver understøttet version. De to fjerner mest gentaget arbejde: spørgsmålet "hvad er der i det?" til engineering og den nye scanning på forespørgsel. Deduplikering af sager, routing, et søgbart bibliotek af VEX og advisories og offentliggørelse i CSAF kommer bagefter.
Hvordan får man engineering til at svare på PSIRT'ets spørgsmål til tiden?
Stil engineering færre spørgsmål. Besvar "er komponenten i produktet?" ud fra build-registreringen, og send kun "kan I rette det inden denne dato?" til engineering. Aftal en ejer pr. produkt, responsmål pr. alvorlighed for rettelsen og en formel risikoaccept, når et mål ikke nås.
Hvorfor betyder en SBOM pr. release noget for et PSIRT?
Kunder kører bestemte versioner, ofte gamle. En SBOM af default-branchen siger intet om version X fra for to år siden. Én SBOM pr. leveret version, registreret fra det build, der producerede den, og gemt i supportperioden, er det, der lader et PSIRT svare for hver version, der stadig er i brug, inklusive eksponeringsvinduet.
Vil kunderne have VEX eller advisories?
Begge dele, til forskellige statusser. VEX fortæller kundernes scannere, hvilke CVE'er der ikke rammer et produkt, så fundene stopper. Advisories fortæller folk, hvad der er berørt, hvad der er rettet, og hvad de skal gøre. At offentliggøre begge dele, maskinlæsbart hvor du kan, besvarer de fleste spørgsmål, før de bliver stillet.
