Gegen ein wachsendes Anfragevolumen können Sie nicht anstellen, und Sie können auch nicht ewig schneller triagieren. Ein PSIRT skaliert, indem es die meisten „Sind wir betroffen?“-Fragen aus Daten beantwortet, die es beim Build jeder Version aufgezeichnet hat, und indem es die Antwort veröffentlicht, bevor Kunden fragen. Der teure Schritt ist heute, die Entwicklung zu fragen, was in einem Produkt steckt. Verlegen Sie diesen Schritt in die Build-Zeit, und die meisten Anfragen werden zu Abfragen, die der Support abschließen kann.
Dieser Beitrag setzt voraus, dass Sie bereits ein PSIRT betreiben; wenn Sie eines aufbauen, beginnen Sie mit was ein PSIRT ist und wie Sie eines aufbauen. Im Folgenden: warum sich das Volumen verändert hat, wohin in der üblichen Pipeline die Zeit geht und was Sie ändern sollten, in dieser Reihenfolge.
Warum sich das Volumen verändert hat
Der Anstieg ist strukturell, kein schlechtes Quartal. Vier Entwicklungen drücken gleichzeitig auf dieselbe Warteschlange.
Mehr CVEs. Das CVE-Programm hat 2024 insgesamt 39.718 CVE-Einträge veröffentlicht und 2025 insgesamt 47.801. 2026 überschritt die Zahl die Jahressumme von 2025 lange vor Jahresende; unsere Live-Statistik der CVE-Veröffentlichungen verfolgt sie Tag für Tag. Das Update der FIRST-Schwachstellenprognose 2026 (15. Juni 2026) hob die Schätzung für das Jahr auf rund 66.000 CVEs an und benannte die Ursache klar: KI kann deutlich mehr Schwachstellen finden als menschliche Analysten, und „der Engpass ist nicht mehr das Finden; es ist die menschliche Kapazität, zu verifizieren, zu koordinieren und zu patchen“. Ein PSIRT ist diese menschliche Kapazität.
Kunden scannen Ihr Produkt. Kunden lassen Scanner über Ihre Images, Ihre Firmware und Ihre Appliances laufen und leiten jeden Befund als Ticket weiter. Die meisten dieser Befunde sind Scanner-Rauschen zu Komponenten, die Sie nicht ausliefern, oder zu Versionen, die nicht betroffen sind, und dieses Rauschen wird zu Ihrem Eingang. Schwachstellen-Rauschen reduzieren behandelt die Scanner-Seite.
Regulierung bringt Fristen. Seit dem 11. September 2026 gelten die Meldepflichten des EU Cyber Resilience Act. Eine aktiv ausgenutzte Schwachstelle in einem in der EU verkauften Produkt erfordert eine Frühwarnung innerhalb von 24 Stunden, nachdem der Hersteller davon Kenntnis erlangt hat.
Weniger Hilfe von der NVD. Am 15. April 2026 hat das NIST die National Vulnerability Database auf risikobasierte Anreicherung umgestellt: CVEs im KEV-Katalog der CISA, von der US-Bundesregierung genutzte Software und kritische Software nach EO 14028 kommen zuerst, der Rest wird als „Lowest Priority - not scheduled for immediate enrichment“ markiert. Weniger CVEs kommen mit CPE-Daten, sodass der Abgleich über Produktnamen genau dann schlechter wird, wenn das Volumen steigt.
| Treiber | Was er mit der Warteschlange des PSIRT macht |
|---|---|
| CVE-Volumen, KI-gestützte Entdeckung | Mehr CVEs in Drittkomponenten pro Produkt zu bewerten, jeden Monat |
| Scans durch Kunden | Mehr Anfragen pro CVE, viele zu Komponenten, die Sie nicht ausliefern |
| CRA-Meldepflichten | Eine 24-Stunden-Frist für aktiv ausgenutzte Schwachstellen |
| Weniger NVD-Anreicherung | Mehr Handarbeit, um eine CVE den Produkten zuzuordnen, die sie betrifft |
Wohin die Zeit geht: die Anfrage-Pipeline, wie sie üblicherweise läuft
Wir hören von Product-Security-Teams immer wieder dieselbe Pipeline. Ein zweiköpfiges PSIRT bei einem Hardwarehersteller hat sie uns so beschrieben: Ein Kunde fragt beim Support an, der Support leitet die Frage über das CRM an das PSIRT weiter, der Fall landet im Tracker des PSIRT, das PSIRT untersucht die Produkte, nach denen Kunden am häufigsten fragen, gibt die Frage dann an die Entwicklung weiter und wartet.
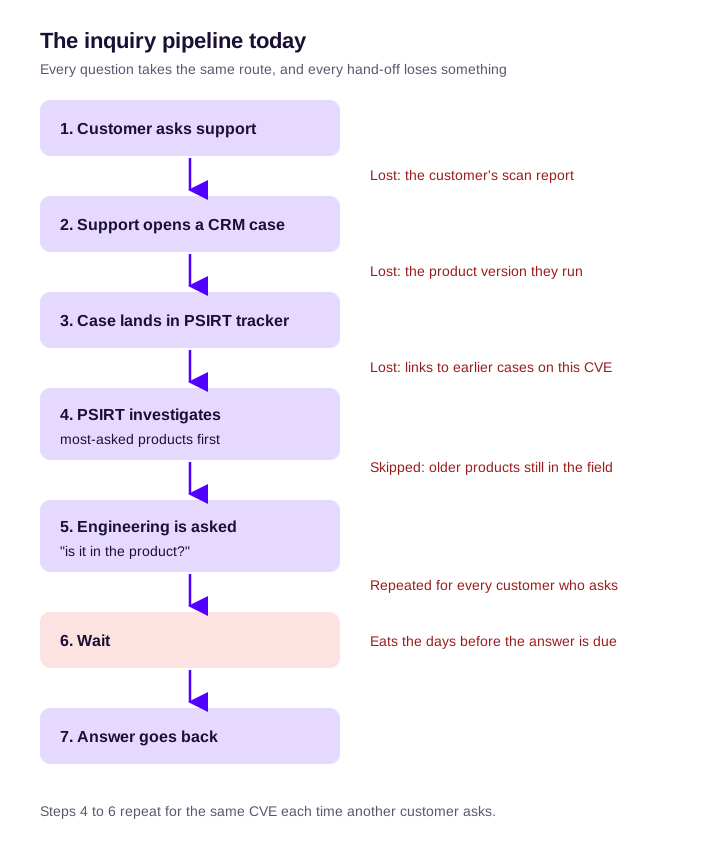
Nehmen Sie eine beispielhafte Anfrage. Ein Kunde leitet einen Scannerbericht weiter, der 40 CVEs für Firmware-Version X auflistet. Der Support eröffnet einen Fall und hängt den Bericht an, aber nicht den genauen Build, den der Kunde einsetzt. Das PSIRT prüft, welche der 40 es bereits bewertet hat, findet ein Dutzend, die es noch nicht bewertet hat, und fragt das zuständige Entwicklungsteam, ob die Komponenten in Version X enthalten sind. Die Entwicklung muss den Quellcode für Version X finden, herausarbeiten, welche Abhängigkeitsversionen darin eingeflossen sind, und antworten. Die Zahlen sind erfunden; das Muster nicht.
Die Analyse selbst kostet selten die meiste Zeit. Zwei versteckte Kosten sind:
- Dieselbe CVE wird für jeden fragenden Kunden erneut untersucht. Wenn die Antwort in einem E-Mail-Verlauf steckt, beginnt die Untersuchung für den nächsten Kunden von vorn.
- „Meistgefragte Produkte zuerst“ lässt den Long Tail unbeantwortet. Ältere Produkte, die noch im Feld sind, werden nie geprüft, und genau dort liegt oft das Risiko: ältere Komponenten, weniger Updates, weniger Leute, die noch wissen, wie sie gebaut wurden.
Eingang: Fragen von Meldungen trennen
Die Schwachstellenmeldung eines Sicherheitsforschers und das „Sind wir betroffen?“ eines Kunden sind unterschiedliche Arbeit und brauchen unterschiedliche Wege. Das FIRST PSIRT Services Framework rechnet bereits mit unsauberem Eingang: Ein PSIRT sollte „damit rechnen, Schwachstellen über verschiedene Kanäle und in unterschiedlicher Qualität zu erhalten“ (Unterfunktion 2.1.1.1). Sein Servicebereich Triage geht weiter: „Wenn Organisationen eine große Zahl von Schwachstellenmeldungen erhalten, können sie eine erste Triage in Betracht ziehen, um Meldungen zu validieren, bevor Fälle angelegt werden.“ Verstehen Sie das als Erlaubnis, nicht für jede Anfrage einen PSIRT-Fall zu eröffnen.
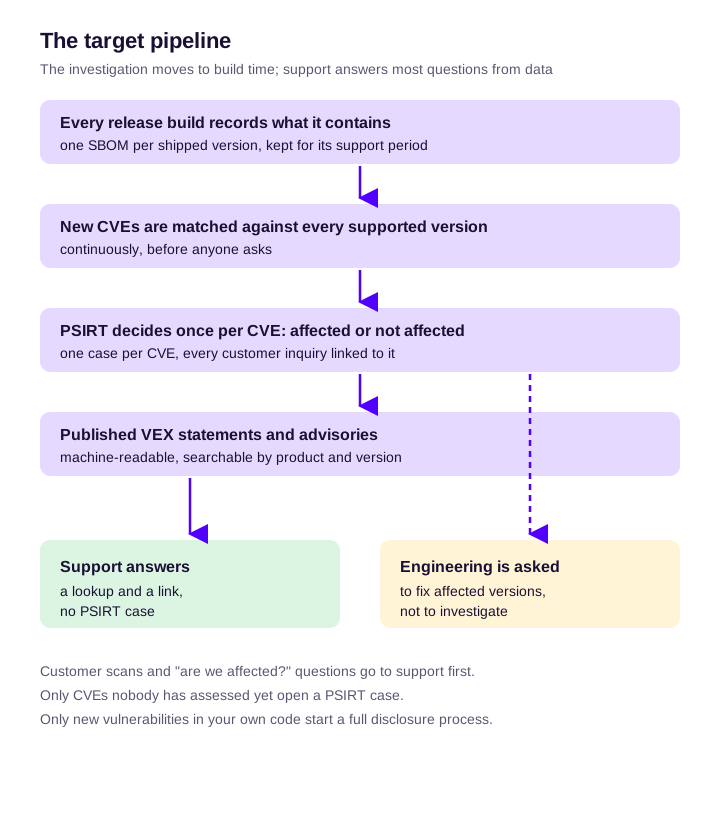
Teilen Sie Anfragen beim Support in drei Wege auf:
| Der Kunde fragt nach | Weg | Wer antwortet |
|---|---|---|
| Einer veröffentlichten CVE in einer Drittkomponente, die Sie bereits bewertet haben | Antwort aus der veröffentlichten VEX-Aussage oder dem Advisory; kein PSIRT-Fall | Support |
| Einer veröffentlichten CVE, die Sie noch nicht bewertet haben | Ein PSIRT-Fall pro CVE, nicht pro Kunde; jede Anfrage wird damit verknüpft | PSIRT, danach antwortet der Support allen Verknüpften |
| Einer neuen Schwachstelle in Ihrem eigenen Code | Eine Schwachstellenmeldung: der vollständige Prozess der koordinierten Offenlegung von Schwachstellen | PSIRT |
Für den ersten Weg braucht der Support zwei Dinge: eine durchsuchbare Liste der bewerteten CVEs pro Produkt und Version und Antwortvorlagen. Wie Sie Kunden nach einem Lieferkettenangriff antworten enthält Vorlagen, die Sie anpassen können.
Erfassen Sie beim Eingang das Produkt und die genaue Version, die der Kunde einsetzt. Ohne die Version lautet jede Antwort „kommt darauf an“, und der Fall kommt zurück.
Nach Exposition priorisieren, nicht nur nach Beliebtheit
„Meistgefragte Produkte zuerst“ ist eine vernünftige Faustregel. Sie braucht eine zweite Achse. Behalten Sie die Beliebtheit (installierte Basis, Umsatz, wie oft der Support fragt) und ergänzen Sie die Exposition: Wird das Produkt noch unterstützt, ist es in typischen Installationen aus dem Internet erreichbar, und steht die CVE im KEV-Katalog der CISA oder hoch im EPSS? Der Leitfaden zur Priorisierung von Schwachstellen behandelt die Signale ausführlich.
| Geringe Exposition | Hohe Exposition | |
|---|---|---|
| Große installierte Basis | Antwort aus dem Inventar; VEX für nicht betroffene Versionen veröffentlichen | Zuerst untersuchen; Advisory und Fix mit der kürzesten Frist |
| Kleine installierte Basis | Antwort aus dem Inventar auf Anfrage; keine proaktive Arbeit | Nicht überspringen: aus dem Inventar antworten, dann über einen Fix oder einen Hinweis zur Abhilfe entscheiden |
Der Sinn der Matrix liegt in der linken Spalte und der unteren Zeile. Der Long Tail bekommt eine Antwort aus Daten, nicht aus einer Untersuchung, für die niemand Zeit hat.
Nach dem CRA entscheidet der Supportzeitraum, den Sie für jedes Produkt angegeben haben, für welche älteren Produkte Sie noch Antworten und Sicherheitsupdates schulden (was der CRA verlangt).
Die Übergabe an die Entwicklung ist der Engpass
Dieser Abschnitt richtet sich an die Entwicklungsleitung, die die Eskalationen des PSIRT erhält.
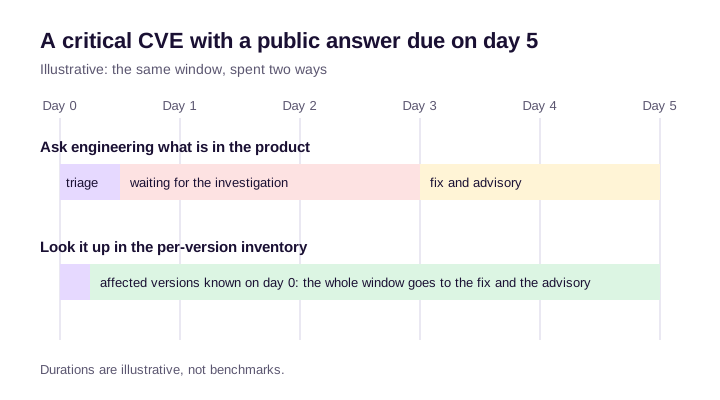
PSIRT-Fristen sind öffentlich: Ein Kunde, eine Aufsichtsbehörde oder ein Offenlegungstermin wartet. Die Fristen der Entwicklung sind es meist nicht, und das PSIRT fängt die Lücke auf. Ein kritisches Problem, das an einem Montag übergeben wird und bis Dienstag keine Antwort hat, lässt zwei Tage, bevor die öffentliche Antwort fällig ist.
Das PSIRT stellt der Entwicklung zwei verschiedene Fragen, und nur eine davon sollte die Entwicklung brauchen:
- „Ist die Komponente im Produkt?“ ist eine Datenfrage. Sie sollte aus einer Aufzeichnung beantwortet werden, nicht von einer Person, die Build-Dateien liest.
- „Können Sie es bis Datum X beheben?“ ist eine Arbeitsfrage. Die gehört zur Entwicklung.
Das FIRST-Framework sagt, wie die erste Frage vom Tisch der Entwicklung kommt. Funktion 2.3.5 fordert PSIRTs auf, „automatisierte Kanäle einzurichten, um festgestellte Schwachstellenmeldungen zu Drittkomponenten direkt an die Entwicklungsteams der betroffenen Produkte zu verteilen“, damit Advisories zu Drittkomponenten im Entwicklungsprozess bearbeitet werden und das PSIRT weniger davon von Hand bearbeitet.
Vereinbaren Sie drei Dinge mit der Entwicklung:
- Einen Verantwortlichen pro Produkt. Bei großen Herstellern ist die Behebung über Produktteams verteilt; das verteilte Modell des Frameworks gibt es, weil es den Auftrag des PSIRT über die Entwickler skalieren lässt, denen die Produkte gehören.
- Reaktionsziele pro Schweregrad, schriftlich festgehalten, für den Fix statt für die Untersuchung.
- Was passiert, wenn ein Ziel verfehlt wird. Funktion 4.2.4 verlangt „einen Prozess zur formellen Risikoakzeptanz für alle Schwachstellen, die nicht innerhalb der internen SLA-Fristen behoben werden“. Jemand mit Befugnis unterzeichnet das Risiko; es bleibt nicht einfach offen.
Der Rhythmus der Fixes ist unterschiedlich. Ein Team liefert über Nacht einen Patch, ein anderes braucht ein sechsmonatiges Plattform-Upgrade. Das Advisory muss sagen, was davon zutrifft, damit Kunden planen können.
„Sind wir betroffen?“ wird zur Abfrage: eine SBOM für jede ausgelieferte Version
Diese Änderung spart die meiste Arbeit. FIRST-Funktion 2.3.1, das Inventar der Produktkomponenten, nennt es „unerlässlich, um Produkte, die von geerbten Schwachstellen betroffen sind, schnell zu identifizieren“. Die PSIRT-Reifegrade ordnen ein Produktregister mit Abhängigkeitszuordnung der mittleren Stufe zu und die Überwachung von Schwachstellen in Produktkomponenten der fortgeschrittenen.
Ein Inventar spart nur dann Arbeit, wenn es dem Volumen standhält. Jede der folgenden Anforderungen hat einen Grund:
- Eine SBOM pro ausgelieferter Version, nicht pro Repository und nicht vom Default-Branch. Kunden setzen Versionen ein, keine Branches.
- Aus dem Build, der das Release erzeugt hat. Ein späterer Rebuild oder ein Scan des heutigen Repositorys beschreibt andere Software (SBOMs zur Build-Zeit).
- Einschließlich transitiver und verborgener Abhängigkeiten. Das verwundbare Paket ist selten eines, das Sie selbst hinzugefügt haben (transitive Abhängigkeiten), und Installationsskripte, Basis-Images und wiederhergestellte Caches bringen Komponenten mit, die in keinem Lockfile stehen.
- Ein Signal für Vollständigkeit. Eine unvollständige Aufzeichnung, die als vollständig behandelt wird, erzeugt selbstsichere „nicht betroffen“-Antworten, die falsch sind.
- Aufbewahrt, solange die Version unterstützt wird. Die Aufzeichnung einer Version von vor drei Jahren ist genau die, die Sie brauchen, wenn niemand mehr weiß, wie sie gebaut wurde.
- Hersteller-SBOMs für zugekaufte Komponenten, damit Drittsoftware im selben Inventar steht wie Ihre eigene.
- Fortlaufend neu abgeglichen, sobald neue CVEs veröffentlicht werden, statt neu gescannt, wenn jemand fragt.
Ein durchgerechnetes Beispiel. Eine neue CVE wird in einer weit verbreiteten Kompressionsbibliothek veröffentlicht. Ohne Inventar fragt das PSIRT jedes Produktteam, die Antworten tröpfeln über Tage ein, und die ältesten Produkte werden nie geprüft. Mit Inventar liefert eine Abfrage die betroffenen Produkte und Versionen, dazu den ersten und den letzten Build, der die verwundbare Version enthielt. Das ist das Expositionsfenster, nach dem Kunden als Nächstes fragen; Sind wir von einer CVE betroffen? zeigt, wie Sie es für einen einzelnen Fall bestimmen.
Embedded- und Yocto-Portfolios haben es am schwersten. Scanner, die ein fertiges Firmware-Image lesen, müssen raten, was hineinkompiliert wurde, und bei Teams, mit denen wir sprechen, sind Proof of Concepts von Scannern an Yocto-basierten Produkten gescheitert. Wer den Build während seiner Ausführung aufzeichnet, muss nicht raten (Yocto-Builds auf CRACI).
Wenn ein Kunde dann die SBOM selbst anfordert, in einem bestimmten Format, lesen Sie SBOM-Anfragen von Kunden beantworten.
Die Ausgabeseite: Advisories und VEX, die antworten, bevor jemand fragt
Die günstigste Anfrage ist die, die nie eintrifft.
- Veröffentlichen Sie „nicht betroffen“ als VEX, damit die Scanner der Kunden die CVE nicht mehr melden, und veröffentlichen Sie „betroffen“ und „behoben“ als Advisories mit genauen Versionen.
- Machen Sie es maschinenlesbar. FIRST-Unterfunktion 5.3.2.3 schlägt vor, dass PSIRTs „in Betracht ziehen, Advisories in einem maschinenlesbaren Format wie dem Common Security Advisory Framework (CSAF) zu veröffentlichen“, damit Kunden sie mit ihren eigenen Tools verarbeiten können. Der CSAF-Leitfaden beschreibt den Weg von Webseiten und RSS-Feeds zu CSAF.
- Informieren Sie den Support vor der Veröffentlichung. Funktion 5.3.4: „Eine vorab erfolgende, vertrauliche Benachrichtigung samt FAQ zu kommenden Advisories bereitet diejenigen vor, die bei der Veröffentlichung dazu befragt werden könnten.“ Der Support kann dann am selben Tag antworten.
- Zustellen, nicht nur aushängen. Unterfunktion 5.4.1.3 merkt an, dass wenige Seitenaufrufe von Advisories „Ihre Strategie in Richtung proaktiver Benachrichtigung lenken können“. Feeds und Benachrichtigungen erreichen Kunden, die nie eine Advisory-Seite besuchen.
Der CRA macht einen Teil davon zur Pflicht. Artikel 14(8) verlangt vom Hersteller, nachdem er von einer aktiv ausgenutzten Schwachstelle oder einem schwerwiegenden Sicherheitsvorfall Kenntnis erlangt hat, die betroffenen Nutzer „und gegebenenfalls alle Nutzer“ zu informieren, und zwar „gegebenenfalls in einem strukturierten, maschinenlesbaren Format, das sich leicht automatisch verarbeiten lässt“. Ein Format nennt die Verordnung nicht.
Was Sie automatisieren, in dieser Reihenfolge
Jeder Schritt beseitigt eine Art von Arbeit; die Kennzahl zeigt, ob er es getan hat.
| Schritt | Arbeit, die er beseitigt | Kennzahl, die den Erfolg zeigt |
|---|---|---|
| 1. Ein Inventar pro Version aus dem Build | Die Frage „Was steckt drin?“ an die Entwicklung | Untersuchungsanfragen an die Entwicklung pro Monat sinken |
| 2. Fortlaufender Abgleich neuer CVEs mit jeder unterstützten Version | Neu scannen auf Anfrage | Zeit von der CVE-Veröffentlichung bis zur Entscheidung betroffen oder nicht betroffen |
| 3. Ein Fall pro CVE, mit verknüpften Anfragen | Doppelte Untersuchungen | Anfragen pro Fall steigen, Fälle pro CVE bleiben bei einem |
| 4. Automatisches Weiterleiten betroffener Befunde an das zuständige Team (FIRST 2.3.5) | Manuelle Übergaben | Zeit von der Entscheidung bis zur Bestätigung durch einen Verantwortlichen |
| 5. Eine durchsuchbare Bibliothek veröffentlichter VEX-Aussagen und Advisories | Beteiligung des PSIRT an wiederkehrenden Fragen | Anteil der vom Support abgeschlossenen Anfragen |
| 6. Maschinenlesbares Veröffentlichen (CSAF) | Kunden, die nach dem fragen, was ihre Tools hätten abrufen können | Anfragen pro veröffentlichtem Advisory sinken |
| 7. KI-Unterstützung beim Entwerfen von Advisories und Antworten | Schreibzeit | Zeit von der Entscheidung bis zum veröffentlichten Advisory |
KI kommt aus gutem Grund zuletzt. Sie entwirft gut auf Grundlage aufgezeichneter Daten, und sie sollte nie die Quelle der Entscheidung „betroffen“ sein.
Manches sollte nicht automatisiert werden: Die Beurteilung „nicht betroffen“ und die Einstufung des Schweregrads bleiben bei einem Menschen, mit beigefügten Belegen. Die Automatisierung entscheidet, wie schnell dieser Mensch die Belege bekommt.
Kennzahlen, die zeigen, dass das PSIRT skaliert
- Der Anteil der Anfragen, die ohne PSIRT-Fall beantwortet werden.
- Die Zeit von der CVE-Veröffentlichung bis zur Entscheidung betroffen oder nicht betroffen, pro Produkt.
- Untersuchungsanfragen an die Entwicklung pro Monat. Sie sollten sinken.
- Die Quote fristgerechter Behebungen nach Schweregrad; die Unterfunktion 4.4.2.4 des Frameworks definiert sie als den Grad, in dem Produktteams die vereinbarte Zeit von der Meldung bis zum Fix einhalten.
- Die Abdeckung der noch unterstützten Versionen durch VEX und Advisories.
Branchen-Benchmarks dafür nennen wir nicht. Keine Primärquelle, der wir vertrauen, veröffentlicht welche.
Wo CRACI passt
CRACI deckt die Schritte 1 und 2 sowie Teile der Schritte 4 und 5 ab, für Software, die in GitHub Actions gebaut wird. Ihre Builds laufen auf den Runnern von CRACI, und CRACI zeichnet während der Ausführung auf, was jeder Job tatsächlich geladen hat: direkte und transitive Abhängigkeiten, von Skripten installierte Pakete und aus CI-Caches wiederhergestellte Pakete. Die SBOM jedes Jobs trägt einen Vollständigkeitsstatus, sodass eine unvollständige Aufzeichnung nie mit einer vollständigen verwechselt wird.
CRACI bewahrt die Build-Historie auf. Wird eine neue CVE veröffentlicht, sehen Sie also, welche Builds die verwundbare Abhängigkeit enthielten und seit wann, so weit Ihre Aufbewahrungsfrist zurückreicht. Überwachte SBOMs werden fortlaufend neu bewertet, Befunde werden über Builds und Repositories hinweg zusammengeführt, und Hersteller-SBOMs lassen sich hinzufügen, sodass zugekaufte Komponenten zusammen mit Ihren eigenen Builds überwacht werden. CRACI benachrichtigt die zuständigen Personen über eine neue Schwachstelle und ihren Schweregrad. Die Inventaransicht zeigt, welche Softwareversionen auf welchen Produkten im Einsatz sind, und Security-Teams triagieren jeden Befund in CRACI und leiten ihn an das Team weiter, das für den Fix zuständig ist. CRACI unterstützt VEX. Siehe CRACI für PSIRTs und Schwachstellen-Tracking.
Sehen Sie, welche Ihrer ausgelieferten Versionen eine CVE enthalten.
Wann CRACI nicht die Antwort ist
- Ihr Engpass sind Eingang und Fallmanagement, der Teil vom CRM bis zum Tracker. CRACI ist kein Werkzeug für Fallmanagement oder die Veröffentlichung von Advisories; für diese Hälfte brauchen Sie ein Fallmanagement-Tool (PSIRT-Tools im Vergleich).
- Ihre Produkte werden nicht in GitHub Actions auf Linux-Runnern gebaut. GitHub Actions ist heute das unterstützte CI; GitLab CI und Jenkins stehen auf der Roadmap, ohne Termin.
- Sie brauchen eine Binär- oder Firmware-Analyse von Produkten, die Sie nicht selbst gebaut haben. Das leisten Tools zur Analyse des Endprodukts (Embedded-Security-Tools im Vergleich).
- Sie brauchen eine Erreichbarkeitsanalyse, um „nicht betroffen“ zu begründen. CRACI bietet sie nicht an.
Häufig gestellte Fragen
Wie skaliert man ein PSIRT, ohne Personal einzustellen?
Hören Sie auf, dieselbe Frage immer wieder zu untersuchen. Zeichnen Sie beim Build auf, was jede ausgelieferte Version enthält, gleichen Sie neue CVEs fortlaufend damit ab, entscheiden Sie einmal pro CVE und veröffentlichen Sie die Entscheidung als VEX oder als Advisory, auf das der Support verweisen kann. Das PSIRT bearbeitet dann die wirklich offenen Fälle, und die Entwicklung wird gebeten, Fehler zu beheben, nicht zu untersuchen.
Wie sollte ein PSIRT mit Kundenanfragen „Sind wir betroffen?“ umgehen?
Behandeln Sie sie als eigenen Eingangskanal, getrennt von Schwachstellenmeldungen. Fragen zu CVEs, die Sie bereits bewertet haben, beantwortet der Support aus veröffentlichtem Material. Eine CVE, die Sie noch nicht bewertet haben, bekommt einen PSIRT-Fall, mit dem jede Kundenanfrage verknüpft wird. Nur eine neue Schwachstelle in Ihrem eigenen Code durchläuft den vollständigen Offenlegungsprozess.
Was sagt das FIRST PSIRT Services Framework zu Volumen und Automatisierung?
Es rechnet mit Meldungen „über verschiedene Kanäle und in unterschiedlicher Qualität“, erlaubt bei hohem Volumen eine Triage, bevor Fälle angelegt werden, nennt ein Inventar der Produktkomponenten „unerlässlich, um betroffene Produkte schnell zu identifizieren“, und verlangt automatisierte Kanäle, die Schwachstellenmeldungen zu Drittkomponenten direkt an die Entwicklungsteams der betroffenen Produkte senden (Funktion 2.3.5).
Was sollte ein PSIRT zuerst automatisieren?
Das Inventar pro Version aus dem Build, danach den fortlaufenden Abgleich neuer CVEs mit jeder unterstützten Version. Diese beiden beseitigen die meiste wiederholte Arbeit: die Frage „Was steckt drin?“ an die Entwicklung und das erneute Scannen auf Anfrage. Deduplizierung von Fällen, Weiterleitung, eine durchsuchbare Bibliothek mit VEX und Advisories und die Veröffentlichung als CSAF folgen danach.
Wie bringt man die Entwicklung dazu, PSIRT-Fragen rechtzeitig zu beantworten?
Stellen Sie der Entwicklung weniger Fragen. Beantworten Sie „Ist die Komponente im Produkt?“ aus der Build-Aufzeichnung, und schicken Sie der Entwicklung nur „Können Sie es bis zu diesem Datum beheben?“. Vereinbaren Sie einen Verantwortlichen pro Produkt, Reaktionsziele pro Schweregrad für den Fix und eine formelle Risikoakzeptanz, wenn ein Ziel verfehlt wird.
Warum ist eine SBOM pro Release für ein PSIRT wichtig?
Kunden setzen bestimmte Versionen ein, oft alte. Eine SBOM des Default-Branch sagt nichts über Version X von vor zwei Jahren. Eine SBOM pro ausgelieferter Version, aufgezeichnet aus dem Build, der sie erzeugt hat, und für den Supportzeitraum aufbewahrt, ermöglicht es einem PSIRT, für jede noch eingesetzte Version zu antworten, einschließlich des Expositionsfensters.
Wollen Kunden VEX oder Advisories?
Beides, für unterschiedliche Status. VEX sagt den Scannern der Kunden, welche CVEs ein Produkt nicht betreffen, sodass die Befunde verschwinden. Advisories sagen Menschen, was betroffen ist, was behoben ist und was zu tun ist. Wer beides veröffentlicht, wo möglich maschinenlesbar, beantwortet die meisten Fragen, bevor sie gestellt werden.
