Rosnącej liczby zapytań nie da się pokonać zatrudnianiem, a triażu nie można przyspieszać w nieskończoność. PSIRT skaluje się wtedy, gdy na większość pytań „czy to nas dotyczy?” odpowiada na podstawie danych zapisanych podczas buildu każdej wersji i gdy publikuje odpowiedź, zanim klienci zapytają. Najdroższym krokiem jest dziś pytanie inżynierów, co jest w produkcie. Wystarczy przenieść ten krok na czas buildu, a większość zapytań staje się wyszukaniem, które dział wsparcia może zamknąć sam.
Ten tekst zakłada, że prowadzą już Państwo PSIRT; jeśli dopiero go Państwo tworzą, warto zacząć od tekstu czym jest PSIRT i jak go zbudować. Poniżej: dlaczego zmieniła się skala, gdzie ucieka czas w typowym procesie i co zmienić, w jakiej kolejności.
Dlaczego zmieniła się skala
Wzrost ma charakter strukturalny, a nie jednorazowy. Na tę samą kolejkę naciskają jednocześnie cztery czynniki.
Więcej CVE. Program CVE opublikował 39 718 rekordów CVE w 2024 roku i 47 801 w 2025 roku. W 2026 roku liczba ta przekroczyła całoroczny wynik z 2025 roku na długo przed końcem roku; nasze bieżące trendy publikacji CVE śledzą ją dzień po dniu. Aktualizacja prognozy podatności na 2026 rok organizacji FIRST (15 czerwca 2026) podniosła szacunek na ten rok do około 66 000 CVE i jasno wskazała przyczynę: AI potrafi znaleźć znacznie więcej błędów niż ludzcy analitycy, a „ograniczeniem nie jest już wykrywanie, lecz ludzka zdolność do weryfikacji, koordynacji i łatania”. PSIRT jest właśnie tą ludzką zdolnością.
Klienci skanują Państwa produkt. Klienci uruchamiają skanery na Państwa obrazach, firmware i urządzeniach i przekazują każde znalezisko jako zgłoszenie. Większość tych znalezisk to szum skanerów dotyczący komponentów, których Państwo nie dostarczają, lub wersji, których problem nie dotyczy, a ten szum staje się Państwa kolejką zgłoszeń. Stronę skanerów omawia tekst ograniczanie szumu podatności.
Regulacje dokładają terminy. Od 11 września 2026 roku obowiązują wymogi raportowania unijnego Cyber Resilience Act. Aktywnie wykorzystywana podatność w produkcie sprzedawanym w UE wymaga wczesnego ostrzeżenia w ciągu 24 godzin od uzyskania o niej wiedzy przez producenta.
Mniej pomocy ze strony NVD. 15 kwietnia 2026 NIST przestawił National Vulnerability Database na wzbogacanie danych według ryzyka: pierwszeństwo mają CVE z katalogu KEV agencji CISA, oprogramowanie używane przez administrację federalną i oprogramowanie krytyczne w rozumieniu EO 14028, a pozostałe są oznaczane jako „Lowest Priority - not scheduled for immediate enrichment” (najniższy priorytet, bez planowanego natychmiastowego wzbogacenia). Mniej CVE trafia do nas z danymi CPE, więc dopasowywanie po nazwie produktu pogarsza się akurat wtedy, gdy rośnie skala.
| Czynnik | Jak wpływa na kolejkę PSIRT |
|---|---|
| Liczba CVE, wykrywanie wspierane przez AI | Co miesiąc więcej zewnętrznych CVE do oceny w każdym produkcie |
| Skanowanie przez klientów | Więcej zapytań na każde CVE, wiele o komponentach, których Państwo nie dostarczają |
| Raportowanie zgodnie z CRA | 24-godzinny termin dla aktywnie wykorzystywanych podatności |
| Mniej wzbogacania w NVD | Więcej ręcznej pracy przy przypisywaniu CVE do produktów, których dotyczy |
Gdzie ucieka czas: typowy przebieg obsługi zapytań
Zespoły bezpieczeństwa produktów opisują nam w kółko ten sam proces. Dwuosobowy PSIRT u producenta sprzętu przedstawił go tak: klient pyta dział wsparcia, wsparcie przekazuje pytanie do PSIRT przez CRM, sprawa trafia do trackera PSIRT, PSIRT bada produkty, o które klienci pytają najczęściej, potem przekazuje pytanie inżynierom i czeka.
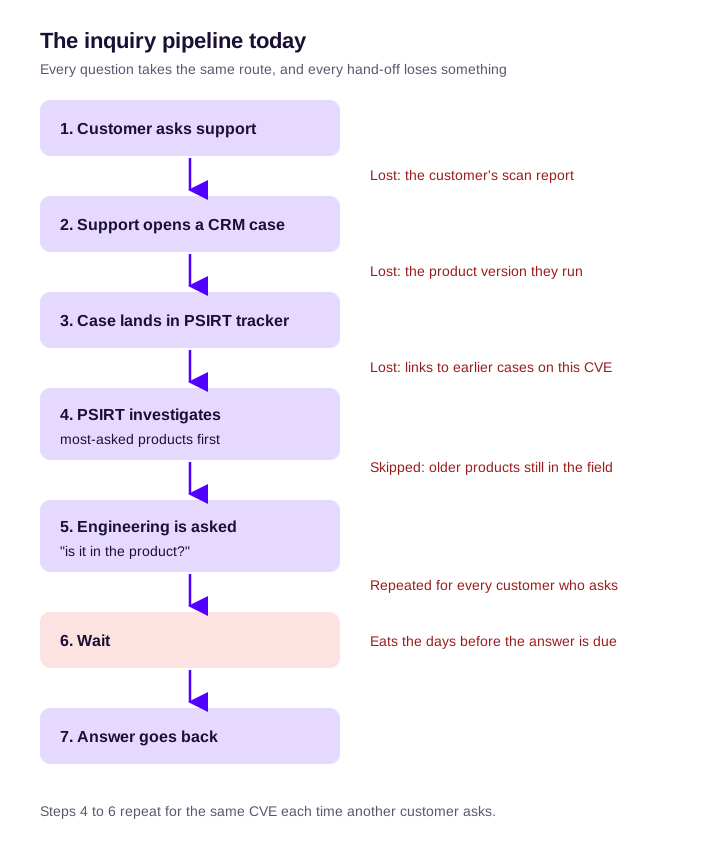
Weźmy przykładowe zapytanie. Klient przesyła raport skanera, który wymienia 40 CVE dla firmware w wersji X. Wsparcie otwiera sprawę i załącza raport, ale nie podaje dokładnego buildu, którego używa klient. PSIRT sprawdza, które z 40 CVE już ocenił, znajduje kilkanaście nieocenionych i pyta odpowiedzialny zespół inżynierski, czy te komponenty są w wersji X. Inżynierowie muszą odnaleźć kod źródłowy wersji X, ustalić, jakie wersje zależności do niej weszły, i odpisać. Liczby są zmyślone; schemat nie.
Sama analiza rzadko zajmuje najwięcej czasu. Dwa ukryte koszty to:
- To samo CVE jest badane od nowa dla każdego pytającego klienta. Gdy odpowiedź żyje w wątku e-mailowym, kolejny klient zaczyna dochodzenie od początku.
- Zasada „najpierw produkty, o które najczęściej pytają” zostawia długi ogon bez odpowiedzi. Starsze produkty wciąż używane u klientów nigdy nie zostają sprawdzone, a właśnie tam często leży ryzyko: starsze komponenty, mniej aktualizacji, mniej osób, które pamiętają, jak je zbudowano.
Przyjmowanie zgłoszeń: oddzielić pytania od zgłoszeń
Zgłoszenie podatności od badacza i pytanie klienta „czy to nas dotyczy?” to różna praca i potrzebują różnych ścieżek. FIRST PSIRT Services Framework już zakłada nieuporządkowane dane wejściowe: PSIRT powinien „spodziewać się otrzymywania podatności różnymi kanałami i o różnej jakości” (podfunkcja 2.1.1.1). Obszar usług triażu idzie dalej: „Organizacje, które otrzymują dużą liczbę zgłoszeń podatności, mogą rozważyć wstępny triaż w celu zweryfikowania zgłoszeń przed utworzeniem spraw”. Można to traktować jako zgodę na to, by nie otwierać sprawy PSIRT dla każdego zapytania.
Zapytania należy rozdzielać już w dziale wsparcia na trzy ścieżki:
| Klient pyta o | Ścieżka | Kto odpowiada |
|---|---|---|
| Opublikowane CVE w zewnętrznym komponencie, które już Państwo ocenili | Odpowiedź na podstawie opublikowanego oświadczenia VEX lub biuletynu; bez sprawy PSIRT | Dział wsparcia |
| Opublikowane CVE, którego jeszcze Państwo nie ocenili | Jedna sprawa PSIRT na CVE, a nie na klienta; każde zapytanie jest do niej powiązane | PSIRT, potem wsparcie odpowiada wszystkim powiązanym |
| Nową podatność we własnym kodzie | Zgłoszenie podatności: pełny proces skoordynowanego ujawniania podatności | PSIRT |
Aby obsługiwać pierwszą ścieżkę, dział wsparcia potrzebuje dwóch rzeczy: przeszukiwalnej listy ocenionych CVE dla każdego produktu i wersji oraz szablonów odpowiedzi. Tekst jak odpowiadać klientom po ataku na łańcuch dostaw zawiera szablony, które można dostosować.
Już przy przyjęciu zapytania należy zapisać produkt i dokładną wersję, której używa klient. Bez wersji każda odpowiedź brzmi „to zależy”, a sprawa wraca.
Priorytety według ekspozycji, nie tylko popularności
Zasada „najpierw produkty, o które najczęściej pytają” jest rozsądną heurystyką. Potrzebuje jednak drugiej osi. Warto zachować popularność (baza instalacji, przychody, częstotliwość pytań od wsparcia) i dodać ekspozycję: czy produkt jest nadal wspierany, czy w typowych wdrożeniach jest dostępny z internetu, czy CVE jest w katalogu KEV agencji CISA lub ma wysoki wynik EPSS? Przewodnik priorytetyzacja podatności szczegółowo omawia te sygnały.
| Niska ekspozycja | Wysoka ekspozycja | |
|---|---|---|
| Duża baza instalacji | Odpowiedź z inwentarza; publikacja VEX dla wersji, których to nie dotyczy | Najpierw analiza; biuletyn i poprawka w najkrótszym terminie |
| Mała baza instalacji | Odpowiedź z inwentarza na żądanie; bez działań proaktywnych | Nie pomijać: odpowiedź z inwentarza, potem decyzja o poprawce lub komunikacie o obejściu |
Sens tej macierzy leży w lewej kolumnie i dolnym wierszu. Długi ogon dostaje odpowiedź z danych, a nie z dochodzenia, na które nikt nie ma czasu.
Zgodnie z CRA okres wsparcia zadeklarowany dla każdego produktu decyduje o tym, dla których starszych produktów wciąż są Państwo winni odpowiedzi i aktualizacje bezpieczeństwa (czego wymaga CRA).
Wąskim gardłem jest przekazanie sprawy inżynierom
Ta sekcja jest dla lidera zespołu inżynierskiego, do którego trafiają eskalacje PSIRT.
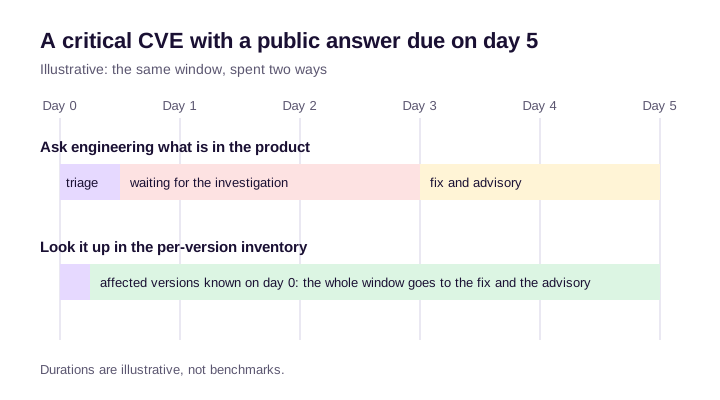
Terminy PSIRT są publiczne: czeka klient, regulator lub data ujawnienia. Terminy inżynierów zwykle nie są, więc różnicę pochłania PSIRT. Krytyczny problem przekazany w poniedziałek, bez odpowiedzi do wtorku, zostawia dwa dni do terminu publicznej odpowiedzi.
PSIRT zadaje inżynierom dwa różne pytania, a tylko jedno z nich powinno wymagać inżynierów:
- „Czy komponent jest w produkcie?” to pytanie o dane. Odpowiedź powinna pochodzić z zapisu, a nie od osoby czytającej pliki buildu.
- „Czy zdążycie to naprawić do dnia X?” to pytanie o pracę. To należy do inżynierów.
Framework FIRST mówi, jak zdjąć pierwsze pytanie z biurka inżynierów. Funkcja 2.3.5 zaleca, by PSIRT „ustanowił zautomatyzowane kanały przekazywania zidentyfikowanych powiadomień o podatnościach zewnętrznych bezpośrednio zespołom deweloperskim dotkniętych produktów”, tak aby zewnętrzne biuletyny były przetwarzane w procesie wytwarzania, a PSIRT obsługiwał ich ręcznie mniej.
Z inżynierami warto uzgodnić trzy rzeczy:
- Właściciela każdego produktu. U dużych producentów naprawy są rozproszone między zespoły produktowe; rozproszony model frameworka istnieje właśnie dlatego, że pozwala skalować misję PSIRT przez inżynierów odpowiedzialnych za produkty.
- Docelowe czasy reakcji dla każdego poziomu wagi, spisane, dotyczące poprawki, a nie analizy.
- Co się dzieje po przekroczeniu terminu. Funkcja 4.2.4 wymaga „procesu formalnej akceptacji ryzyka dla wszystkich podatności, które nie zostały usunięte w czasie wymaganym przez wewnętrzne SLA”. Ktoś z odpowiednimi uprawnieniami podpisuje się pod ryzykiem; sprawa nie wisi po prostu otwarta.
Tempo poprawek bywa różne. Jeden zespół wydaje łatkę w nocy, inny potrzebuje półrocznej aktualizacji platformy. Biuletyn musi to powiedzieć, aby klienci mogli planować.
Zamienić „czy to nas dotyczy?” w wyszukanie: SBOM dla każdej dostarczonej wersji
To zmiana, która usuwa najwięcej pracy. Funkcja FIRST 2.3.1, inwentarz komponentów produktu, nazywa go „niezbędnym do szybkiej identyfikacji produktów dotkniętych odziedziczonymi podatnościami”. Poziomy dojrzałości PSIRT umieszczają rejestr produktów z mapowaniem zależności na poziomie średnim, a monitorowanie podatności komponentów produktu na poziomie zaawansowanym.
Inwentarz usuwa pracę tylko wtedy, gdy wytrzymuje skalę. Każde z poniższych wymagań ma swój powód:
- Jeden SBOM na każdą dostarczoną wersję, a nie na repozytorium i nie z gałęzi domyślnej. Klienci używają wersji, nie gałęzi.
- Pochodzący z buildu, który wytworzył wydanie. Późniejszy ponowny build lub skan dzisiejszego repozytorium opisuje inne oprogramowanie (SBOM-y z czasu buildu).
- Z zależnościami przechodnimi i ukrytymi. Podatny pakiet rzadko jest tym, który dodali Państwo sami (zależności przechodnie), a skrypty instalacyjne, obrazy bazowe i przywrócone cache wprowadzają komponenty, których nie wymienia żaden lockfile.
- Sygnał kompletności. Częściowy zapis traktowany jak pełny daje pewne siebie odpowiedzi „nie dotyczy”, które są błędne.
- Przechowywany tak długo, jak wersja jest wspierana. Zapis wersji sprzed trzech lat będzie potrzebny wtedy, gdy nikt już nie pamięta, jak ją zbudowano.
- SBOM-y dostawców dla kupionych komponentów, aby oprogramowanie zewnętrzne było w tym samym inwentarzu co Państwa własne.
- Dopasowywany na bieżąco w miarę publikacji nowych CVE, zamiast ponownego skanowania, gdy ktoś zapyta.
Przykład. Zostaje opublikowane nowe CVE w szeroko używanej bibliotece kompresji. Bez inwentarza PSIRT pyta każdy zespół produktowy, odpowiedzi spływają przez kilka dni, a najstarsze produkty nigdy nie zostają sprawdzone. Z inwentarzem jedno zapytanie zwraca dotknięte produkty i wersje oraz pierwszy i ostatni build, który zawierał podatną wersję. To okno ekspozycji, o które klienci pytają w następnej kolejności; tekst czy to nas dotyczy? pokazuje, jak je ustalić w pojedynczym przypadku.
Najtrudniej mają portfolio embedded i Yocto. Skanery czytające gotowy obraz firmware muszą zgadywać, co zostało w nim skompilowane, a zespoły, z którymi rozmawiamy, widziały, jak proof of concept skanerów zawodził na produktach opartych na Yocto. Rejestrowanie buildu w trakcie jego działania eliminuje zgadywanie (buildy Yocto w CRACI).
Gdy klient poprosi potem o sam SBOM w określonym formacie, pomocny będzie tekst odpowiadanie na prośby klientów o SBOM.
Strona wyjściowa: biuletyny i VEX, które odpowiadają, zanim ktoś zapyta
Najtańsze zapytanie to takie, które nigdy nie nadchodzi.
- Publikować „not affected” jako VEX, aby skanery klientów przestały oznaczać dane CVE, a „affected” i „fixed” publikować jako biuletyny z dokładnymi wersjami.
- W formie czytelnej maszynowo. Podfunkcja FIRST 5.3.2.3 sugeruje, by PSIRT „rozważył publikowanie biuletynów w formacie czytelnym maszynowo, takim jak Common Security Advisory Framework (CSAF)”, aby klienci mogli je przetwarzać własnymi narzędziami. Przewodnik po CSAF opisuje, jak przejść ze stron internetowych i kanałów RSS na CSAF.
- Przygotować dział wsparcia przed publikacją. Funkcja 5.3.4: „Wcześniejsze, poufne powiadomienie i FAQ dotyczące nadchodzących biuletynów przygotowują osoby, które mogą zostać o nie zapytane po publikacji”. Wsparcie może wtedy odpowiadać już w dniu publikacji.
- Wysyłać, a nie tylko publikować. Podfunkcja 5.4.1.3 zauważa, że niska liczba wyświetleń biuletynów „może skłonić do przyjęcia strategii proaktywnego powiadamiania”. Kanały i powiadomienia docierają do klientów, którzy nigdy nie odwiedzają strony z biuletynami.
CRA czyni część tego obowiązkiem. Artykuł 14(8) wymaga, by producent po uzyskaniu wiedzy o aktywnie wykorzystywanej podatności lub poważnym incydencie poinformował użytkowników, których to dotyczy, „oraz, w stosownych przypadkach, wszystkich użytkowników”, i to „w stosownych przypadkach w ustrukturyzowanym, nadającym się do odczytu maszynowego formacie, który można łatwo przetwarzać automatycznie”. Rozporządzenie nie wskazuje konkretnego formatu.
Co automatyzować i w jakiej kolejności
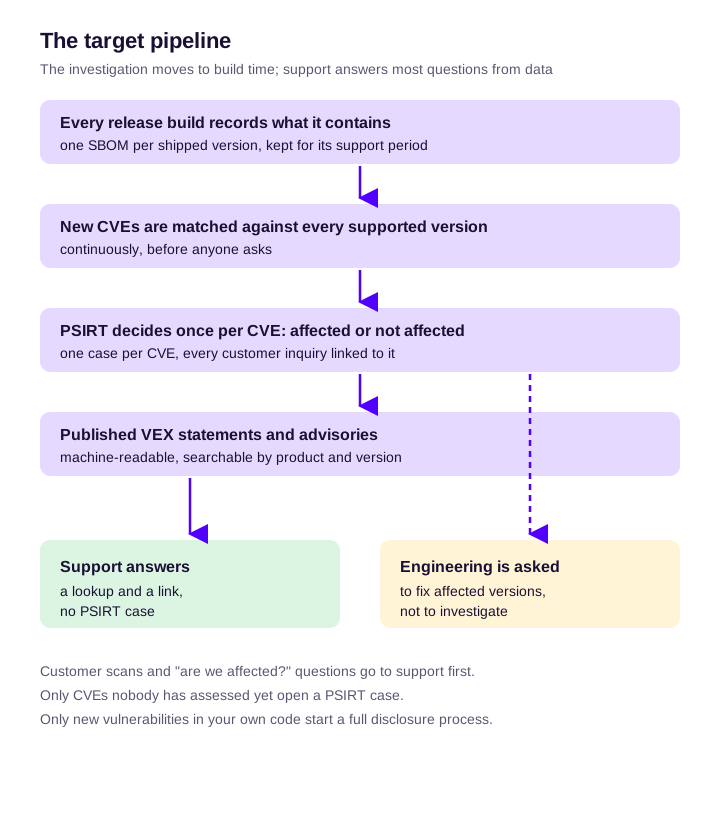
Każdy krok usuwa jakiś rodzaj pracy; wskaźnik pokazuje, czy to się udało.
| Krok | Jaką pracę usuwa | Wskaźnik, który pokazuje efekt |
|---|---|---|
| 1. Inwentarz dla każdej wersji, pochodzący z buildu | Pytanie do inżynierów „co w tym jest?” | Spada liczba próśb o analizę inżynierską miesięcznie |
| 2. Ciągłe dopasowywanie nowych CVE do każdej wspieranej wersji | Ponowne skanowanie na żądanie | Czas od publikacji CVE do decyzji „dotyczy” lub „nie dotyczy” |
| 3. Jedna sprawa na CVE, z powiązanymi zapytaniami | Zdublowane analizy | Rośnie liczba zapytań na sprawę, liczba spraw na CVE pozostaje 1 |
| 4. Automatyczne kierowanie dotkniętych znalezisk do odpowiedzialnego zespołu (FIRST 2.3.5) | Ręczne przekazywanie | Czas od decyzji do potwierdzenia przez właściciela |
| 5. Przeszukiwalna biblioteka opublikowanych oświadczeń VEX i biuletynów | Udział PSIRT w powtarzających się pytaniach | Odsetek zapytań zamykanych przez dział wsparcia |
| 6. Publikowanie w formacie czytelnym maszynowo (CSAF) | Klienci proszący o to, co ich narzędzia mogłyby same pobrać | Spada liczba zapytań na opublikowany biuletyn |
| 7. Wsparcie AI przy redagowaniu biuletynów i odpowiedzi | Czas pisania | Czas od decyzji do opublikowania biuletynu |
AI jest na końcu nie bez powodu. Dobrze redaguje na podstawie zapisanych danych, ale nigdy nie powinna być źródłem decyzji „dotyczy”.
Niektórych rzeczy nie należy automatyzować: ocena „nie dotyczy” i ustalenie wagi pozostają w rękach człowieka, z dołączonymi dowodami. Automatyzacja decyduje o tym, jak szybko ta osoba dostaje dowody.
Wskaźniki, które pokazują, że PSIRT się skaluje
- Odsetek zapytań, na które odpowiedziano bez sprawy PSIRT.
- Czas od publikacji CVE do decyzji „dotyczy” lub „nie dotyczy”, dla każdego produktu.
- Liczba próśb o analizę inżynierską miesięcznie. Powinna spadać.
- Odsetek napraw w terminie według wagi; podfunkcja 4.4.2.4 frameworka definiuje go jako stopień, w jakim zespoły produktowe dotrzymują uzgodnionego czasu od zgłoszenia do poprawki.
- Pokrycie VEX i biuletynami wersji, które Państwo nadal wspierają.
Nie podajemy dla nich branżowych wartości odniesienia. Żadne pierwotne źródło, któremu ufamy, ich nie publikuje.
Miejsce CRACI
CRACI obejmuje kroki 1 i 2 oraz część kroków 4 i 5 dla oprogramowania budowanego w GitHub Actions. Państwa buildy działają na runnerach CRACI, a CRACI rejestruje, co każde zadanie faktycznie pobrało w trakcie działania: zależności bezpośrednie i przechodnie, pakiety instalowane przez skrypty oraz pakiety przywrócone z cache CI. SBOM każdego zadania ma stan kompletności, więc częściowy zapis nigdy nie zostanie wzięty za pełny.
CRACI przechowuje historię buildów, więc gdy zostaje opublikowane nowe CVE, widać, które buildy zawierały podatną zależność i od kiedy, tak daleko wstecz, jak sięga okres przechowywania. Monitorowane SBOM-y są oceniane na bieżąco, znaleziska są agregowane z buildów i repozytoriów, a SBOM-y dostawców można dodać, aby kupione komponenty były monitorowane razem z Państwa własnymi buildami. CRACI powiadamia właściwe osoby o nowej podatności i jej wadze. Widok inwentarza pokazuje, które wersje oprogramowania są wdrożone w których produktach, a zespoły bezpieczeństwa prowadzą w CRACI triaż każdego znaleziska i kierują je do zespołu odpowiedzialnego za poprawkę. CRACI obsługuje VEX. Więcej: CRACI dla zespołów PSIRT i śledzenie podatności.
Proszę sprawdzić, które z dostarczonych wersji zawierają dane CVE.
Kiedy CRACI nie jest rozwiązaniem
- Wąskim gardłem jest przyjmowanie zgłoszeń i zarządzanie sprawami, czyli odcinek od CRM do trackera. CRACI nie jest narzędziem do zarządzania sprawami ani do publikowania biuletynów; do tej części potrzebne jest narzędzie do obsługi spraw (porównanie narzędzi PSIRT).
- Państwa produkty nie są budowane w GitHub Actions na runnerach Linux. GitHub Actions to obecnie obsługiwany system CI; GitLab CI i Jenkins są na roadmapie, bez daty.
- Potrzebują Państwo analizy binariów lub firmware produktów, których nie budowali Państwo sami. Do tego służą narzędzia analizujące gotowy produkt (porównanie narzędzi bezpieczeństwa embedded).
- Potrzebują Państwo analizy osiągalności, aby uzasadnić „nie dotyczy”. CRACI jej nie oferuje.
Najczęściej zadawane pytania
Jak skalować PSIRT bez zatrudniania?
Przestać wielokrotnie badać to samo pytanie. Zapisywać, co zawiera każda dostarczona wersja w chwili jej buildu, na bieżąco dopasowywać do tego nowe CVE, decydować raz na CVE i publikować decyzję jako VEX lub biuletyn, na który dział wsparcia może się powołać. PSIRT zajmuje się wtedy sprawami naprawdę otwartymi, a inżynierów prosi się o poprawki, a nie o analizy.
Jak PSIRT powinien obsługiwać pytania klientów „czy to nas dotyczy?”?
Traktować je jako osobny strumień zgłoszeń, oddzielny od zgłoszeń podatności. Na pytania o CVE, które już Państwo ocenili, dział wsparcia odpowiada na podstawie opublikowanych materiałów. CVE, którego jeszcze nie oceniono, dostaje jedną sprawę PSIRT, z którą powiązane jest każde zapytanie klienta. Tylko nowa podatność we własnym kodzie przechodzi pełny proces ujawniania.
Co FIRST PSIRT Services Framework mówi o skali i automatyzacji?
Zakłada zgłoszenia przychodzące „różnymi kanałami i o różnej jakości”, dopuszcza triaż przed utworzeniem spraw przy dużej liczbie zgłoszeń, nazywa inwentarz komponentów produktu „niezbędnym do szybkiej identyfikacji dotkniętych produktów” i zaleca zautomatyzowane kanały, które przesyłają powiadomienia o podatnościach zewnętrznych bezpośrednio zespołom deweloperskim dotkniętych produktów (funkcja 2.3.5).
Co PSIRT powinien zautomatyzować najpierw?
Inwentarz dla każdej wersji, pochodzący z buildu, a potem ciągłe dopasowywanie nowych CVE do każdej wspieranej wersji. Te dwa kroki usuwają najwięcej powtarzalnej pracy: pytanie do inżynierów „co w tym jest?” i ponowne skanowanie na żądanie. Deduplikacja spraw, kierowanie, przeszukiwalna biblioteka VEX i biuletynów oraz publikowanie w CSAF przychodzą później.
Jak sprawić, by inżynierowie odpowiadali na pytania PSIRT na czas?
Zadawać inżynierom mniej pytań. Na pytanie „czy komponent jest w produkcie?” odpowiadać na podstawie zapisu buildu, a inżynierom wysyłać tylko pytanie „czy zdążycie to naprawić do tego dnia?”. Uzgodnić właściciela każdego produktu, docelowe czasy poprawki dla każdego poziomu wagi i formalną akceptację ryzyka po przekroczeniu terminu.
Dlaczego SBOM dla każdego wydania ma znaczenie dla PSIRT?
Klienci używają konkretnych wersji, często starych. SBOM gałęzi domyślnej nie mówi nic o wersji X sprzed dwóch lat. Jeden SBOM na każdą dostarczoną wersję, zapisany podczas buildu, który ją wytworzył, i przechowywany przez okres wsparcia, pozwala PSIRT odpowiadać za każdą wersję wciąż używaną u klientów, łącznie z oknem ekspozycji.
Czy klienci chcą VEX, czy biuletynów?
Jednego i drugiego, dla różnych statusów. VEX mówi skanerom klientów, które CVE nie dotyczą produktu, więc znaleziska znikają. Biuletyny mówią ludziom, czego problem dotyczy, co zostało naprawione i co zrobić. Publikowanie obu, w miarę możliwości w formacie czytelnym maszynowo, odpowiada na większość pytań, zanim zostaną zadane.
