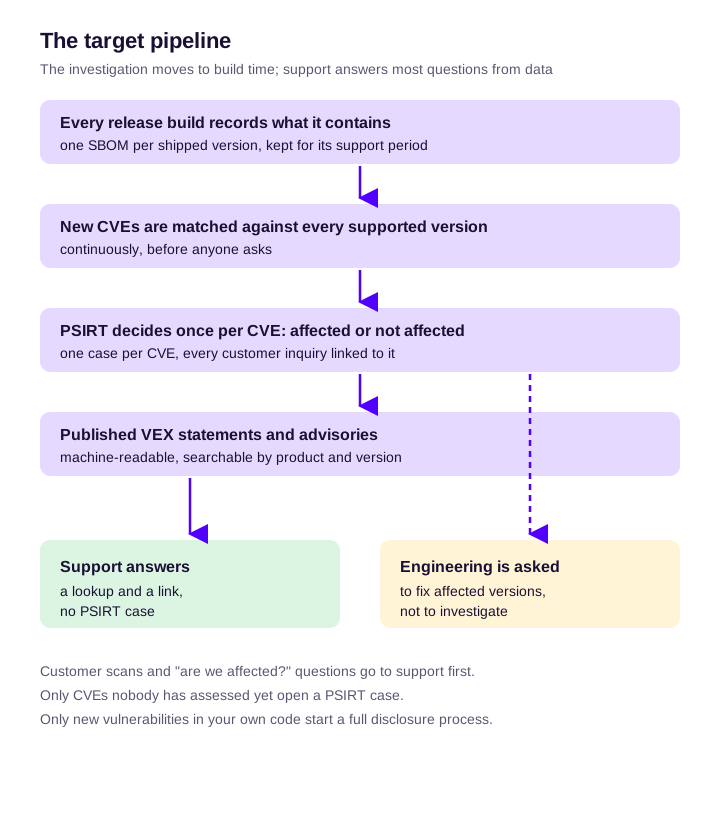
Non si esce da un volume crescente di richieste assumendo personale, e non si può accelerare il triage all'infinito. Un PSIRT scala rispondendo alla maggior parte delle domande "siamo coinvolti?" con i dati registrati quando ogni versione è stata compilata, e pubblicando la risposta prima che i clienti la chiedano. Oggi il passaggio costoso è chiedere all'engineering che cosa contiene un prodotto. Sposti quel passaggio al momento della build, e la maggior parte delle richieste diventa una consultazione che il supporto può chiudere.
Questo articolo presuppone che Lei gestisca già un PSIRT; se lo sta creando, parta da che cos'è un PSIRT e come crearne uno. Di seguito: perché il volume è cambiato, dove va il tempo nella pipeline abituale e che cosa cambiare, in ordine.
Perché il volume è cambiato
L'aumento è strutturale, non un trimestre sfortunato. Quattro fattori premono contemporaneamente sulla stessa coda.
Più CVE. Il CVE Program ha pubblicato 39.718 record CVE nel 2024 e 47.801 nel 2025. Nel 2026 il conteggio ha superato il totale dell'intero 2025 ben prima della fine dell'anno; le nostre tendenze di pubblicazione delle CVE in tempo reale lo seguono giorno per giorno. L'aggiornamento 2026 della previsione sulle vulnerabilità di FIRST (15 giugno 2026) ha alzato la stima per l'anno a circa 66.000 CVE e ha indicato la causa senza giri di parole: l'IA può trovare molte più falle degli analisti umani, e «il vincolo non è più la scoperta; è la capacità umana di verificare, coordinare e correggere». Un PSIRT è proprio quella capacità umana.
I clienti scansionano il Suo prodotto. I clienti eseguono scanner sulle Sue immagini, sul Suo firmware e sulle Sue appliance e inoltrano ogni risultato come ticket. La maggior parte di questi risultati è rumore degli scanner su componenti che Lei non distribuisce o su versioni non interessate, e quel rumore diventa il Suo intake. Ridurre il rumore delle vulnerabilità tratta il lato degli scanner.
La regolamentazione aggiunge scadenze. Dall'11 settembre 2026 si applicano gli obblighi di segnalazione del Cyber Resilience Act dell'UE. Una vulnerabilità attivamente sfruttata in un prodotto venduto nell'UE richiede un preallarme entro 24 ore da quando il fabbricante ne viene a conoscenza.
Meno aiuto dalla NVD. Il 15 aprile 2026 il NIST ha portato la National Vulnerability Database a un arricchimento basato sul rischio: hanno la precedenza le CVE nel catalogo KEV della CISA, il software usato dal governo federale e il software critico ai sensi dell'EO 14028, mentre le altre sono contrassegnate come "Lowest Priority - not scheduled for immediate enrichment" (priorità minima, arricchimento immediato non pianificato). Meno CVE arrivano con dati CPE, quindi l'abbinamento per nome di prodotto peggiora proprio mentre il volume cresce.
| Fattore | Effetto sulla coda del PSIRT |
|---|---|
| Volume di CVE, scoperta assistita dall'IA | Più CVE di terze parti da valutare per prodotto, ogni mese |
| Scansioni dei clienti | Più richieste per CVE, molte su componenti che Lei non distribuisce |
| Segnalazioni ai sensi del CRA | Una scadenza di 24 ore per le vulnerabilità attivamente sfruttate |
| Meno arricchimento della NVD | Più lavoro manuale per collegare una CVE ai prodotti che colpisce |
Dove va il tempo: la pipeline delle richieste così come funziona di solito
Sentiamo descrivere la stessa pipeline dai team di sicurezza di prodotto di continuo. Un PSIRT di due persone presso un produttore di hardware ce l'ha descritta così: un cliente chiede all'help desk, il supporto inoltra la domanda al PSIRT tramite il CRM, il caso finisce nel tracker del PSIRT, il PSIRT indaga sui prodotti di cui i clienti chiedono più spesso, poi passa la domanda all'engineering e aspetta.
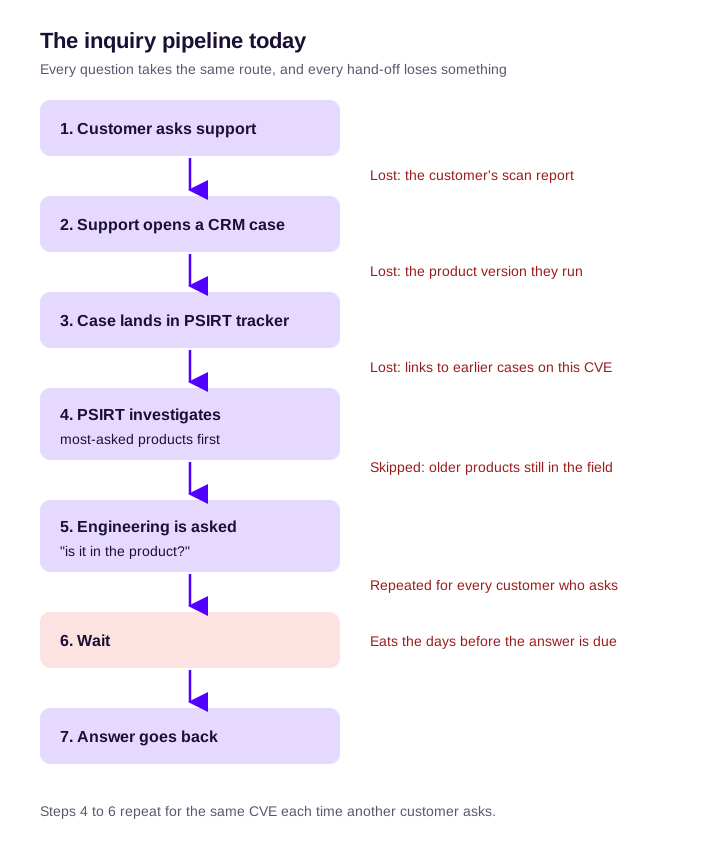
Prendiamo una richiesta a titolo illustrativo. Un cliente inoltra il report di uno scanner che elenca 40 CVE sulla versione X del firmware. Il supporto apre un caso e allega il report, ma non la build esatta che il cliente utilizza. Il PSIRT verifica quali delle 40 ha già valutato, ne trova una dozzina che non ha valutato e chiede al team di engineering responsabile se i componenti sono nella versione X. L'engineering deve trovare il sorgente della versione X, ricostruire quali versioni delle dipendenze vi sono entrate e rispondere. I numeri sono inventati; lo schema no.
L'analisi in sé raramente è ciò che richiede tempo. Due costi nascosti sono:
- La stessa CVE viene indagata di nuovo per ogni cliente che chiede. Quando la risposta vive in un thread di email, il cliente successivo fa ripartire l'indagine da zero.
- "Prima i prodotti più richiesti" lascia senza risposta la coda lunga. I prodotti più vecchi ancora in campo non vengono mai verificati, ed è spesso lì che si trova il rischio: componenti più vecchi, meno aggiornamenti, meno persone che ricordano come sono stati compilati.
Intake: separare le domande dalle segnalazioni
La segnalazione di una vulnerabilità da parte di un ricercatore e il "siamo coinvolti?" di un cliente sono lavori diversi e richiedono percorsi diversi. Il FIRST PSIRT Services Framework prevede già un input disordinato: un PSIRT dovrebbe «aspettarsi di ricevere vulnerabilità attraverso vari canali e di qualità variabile» (sotto-funzione 2.1.1.1). La sua area di servizio dedicata al triage va oltre: «Laddove le organizzazioni ricevono un volume elevato di segnalazioni di vulnerabilità, possono valutare l'esecuzione di un triage iniziale per convalidare le segnalazioni prima che vengano creati i casi.» Lo consideri un permesso a non aprire un caso PSIRT per ogni richiesta.
Suddivida le richieste all'help desk in tre percorsi:
| Il cliente chiede di | Percorso | Chi risponde |
|---|---|---|
| Una CVE pubblicata in un componente di terze parti che ha già valutato | Risposta dalla dichiarazione VEX o dall'advisory pubblicati; nessun caso PSIRT | Supporto |
| Una CVE pubblicata che non ha ancora valutato | Un caso PSIRT per CVE, non per cliente; ogni richiesta viene collegata a quel caso | Il PSIRT, poi il supporto risponde a tutti i collegati |
| Una nuova vulnerabilità nel Suo codice | Una segnalazione di vulnerabilità: l'intero processo di divulgazione coordinata delle vulnerabilità | PSIRT |
Per gestire il primo percorso il supporto ha bisogno di due cose: un elenco consultabile delle CVE valutate per prodotto e versione, e modelli di risposta. Come rispondere ai clienti dopo un attacco alla supply chain contiene modelli che può adattare.
Registri all'intake il prodotto e la versione esatta che il cliente utilizza. Senza la versione ogni risposta è "dipende", e il caso torna indietro.
Dare priorità in base all'esposizione, non solo alla popolarità
"Prima i prodotti più richiesti" è un'euristica ragionevole. Le serve un secondo asse. Mantenga la popolarità (base installata, fatturato, frequenza delle domande del supporto) e aggiunga l'esposizione: il prodotto è ancora supportato, è esposto a internet nelle installazioni tipiche, e la CVE è nel catalogo KEV della CISA o ha un punteggio EPSS elevato? La guida alla prioritizzazione delle vulnerabilità tratta i segnali in modo approfondito.
| Bassa esposizione | Alta esposizione | |
|---|---|---|
| Base installata ampia | Risposta dall'inventario; VEX pubblicato per le versioni non coinvolte | Indagare per primo; advisory e correzione con la scadenza più breve |
| Base installata ridotta | Risposta dall'inventario su richiesta; nessun lavoro proattivo | Non tralasciarlo: risposta dall'inventario, poi decidere tra una correzione e un avviso di mitigazione |
Il senso della matrice sta nella colonna di sinistra e nella riga in basso. La coda lunga riceve una risposta dai dati, non da un'indagine per cui nessuno ha tempo.
Ai sensi del CRA, il periodo di supporto che ha dichiarato per ogni prodotto stabilisce per quali prodotti più vecchi deve ancora risposte e aggiornamenti di sicurezza (che cosa richiede il CRA).
Il passaggio all'engineering è il collo di bottiglia
Questa sezione è per il responsabile di engineering che riceve le escalation del PSIRT.
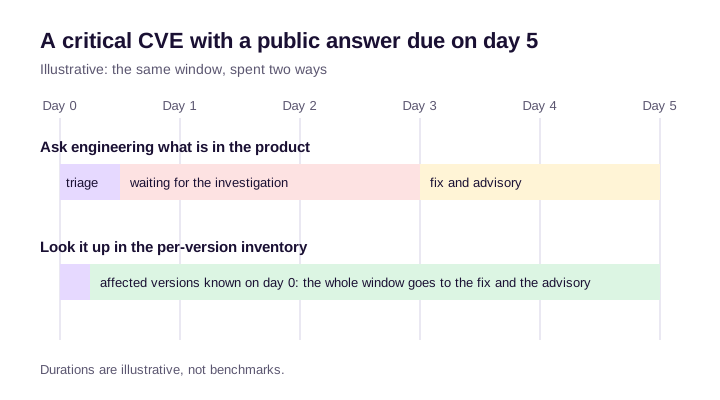
Le scadenze del PSIRT sono pubbliche: un cliente, un'autorità di regolamentazione o una data di divulgazione sono in attesa. Quelle dell'engineering di solito non lo sono, quindi il PSIRT assorbe la differenza. Un problema critico passato di lunedì senza risposta entro martedì lascia due giorni prima della scadenza della risposta pubblica.
Il PSIRT pone all'engineering due domande diverse, e solo una dovrebbe richiedere l'engineering:
- "Il componente è nel prodotto?" è una domanda sui dati. Dovrebbe avere risposta da un registro, non da una persona che legge i file di build.
- "Potete correggerlo entro la data X?" è una domanda sul lavoro. Quella spetta all'engineering.
Il framework FIRST indica come togliere la prima domanda dalla scrivania dell'engineering. La funzione 2.3.5 chiede ai PSIRT di «stabilire canali automatizzati per distribuire le notifiche di vulnerabilità di terze parti individuate direttamente ai team di sviluppo dei prodotti interessati», in modo che gli advisory di terze parti vengano elaborati nel processo di sviluppo e il PSIRT ne gestisca meno a mano.
Concordi tre cose con l'engineering:
- Un responsabile per prodotto. Nei grandi vendor la remediation è distribuita tra i team di prodotto; il modello distribuito del framework esiste perché consente alla missione del PSIRT di scalare attraverso gli ingegneri che possiedono i prodotti.
- Obiettivi di risposta per gravità, messi per iscritto, per la correzione e non per l'indagine.
- Che cosa succede quando un obiettivo non viene rispettato. La funzione 4.2.4 chiede «un processo di accettazione formale del rischio per tutte le vulnerabilità non corrette entro i tempi previsti dagli SLA interni». Qualcuno con l'autorità per farlo firma il rischio; non resta semplicemente aperto.
I tempi di correzione variano. Un team rilascia una patch durante la notte, un altro ha bisogno di un aggiornamento di piattaforma di sei mesi. L'advisory deve dire quale dei due, così i clienti possono pianificare.
Trasformare "siamo coinvolti?" in una consultazione: una SBOM per ogni versione distribuita
Questo è il cambiamento che elimina più lavoro. La funzione FIRST 2.3.1, l'inventario dei componenti di prodotto, lo definisce «essenziale per identificare rapidamente i prodotti interessati da vulnerabilità ereditate». I livelli di maturità del PSIRT collocano un registro dei prodotti con mappatura delle dipendenze al livello intermedio e il monitoraggio delle vulnerabilità dei componenti di prodotto a quello avanzato.
Un inventario elimina lavoro solo se regge il volume. Ogni requisito che segue ha una ragione:
- Una SBOM per ogni versione distribuita, non per repository e non del branch predefinito. I clienti usano versioni, non branch.
- Ricavata dalla build che ha prodotto la release. Una build successiva, o una scansione del repository di oggi, descrive un software diverso (SBOM in fase di build).
- Comprese le dipendenze transitive e nascoste. Il pacchetto vulnerabile raramente è uno che ha aggiunto Lei (dipendenze transitive), e script di installazione, immagini base e cache ripristinate introducono componenti che nessun lockfile elenca.
- Un segnale di completezza. Un registro parziale trattato come completo produce risposte "non coinvolti" sicure di sé e sbagliate.
- Conservata finché la versione è supportata. Il registro di una versione di tre anni fa è quello che Le servirà quando nessuno ricorderà come è stata compilata.
- SBOM dei vendor per i componenti acquistati, così il software di terze parti si trova nello stesso inventario del Suo.
- Confrontata di continuo man mano che vengono pubblicate nuove CVE, invece di essere riscansionata quando qualcuno chiede.
Un esempio concreto. Viene pubblicata una nuova CVE in una libreria di compressione molto diffusa. Senza l'inventario, il PSIRT interpella ogni team di prodotto, le risposte arrivano col contagocce nel corso di giorni e i prodotti più vecchi non vengono mai verificati. Con l'inventario, una sola query restituisce i prodotti e le versioni interessati, più la prima e l'ultima build che contenevano la versione vulnerabile. È la finestra di esposizione su cui i clienti chiedono subito dopo; siamo coinvolti da una CVE? mostra come stabilirla per un singolo caso.
I portafogli embedded e Yocto sono quelli messi peggio. Gli scanner che leggono un'immagine firmware finita devono indovinare che cosa vi è stato compilato, e i team con cui parliamo hanno visto fallire proof of concept di scanner su prodotti basati su Yocto. Registrare la build mentre viene eseguita evita di dover indovinare (build Yocto su CRACI).
Quando poi un cliente chiede la SBOM stessa, in un formato particolare, veda rispondere alle richieste di SBOM dei clienti.
Il lato dell'output: advisory e VEX che rispondono prima che qualcuno chieda
La richiesta più economica è quella che non arriva mai.
- Pubblichi "non coinvolto" come VEX, così gli scanner dei clienti smettono di segnalare la CVE, e pubblichi "coinvolto" e "corretto" come advisory con le versioni esatte.
- Lo renda leggibile dalle macchine. La sotto-funzione FIRST 5.3.2.3 suggerisce ai PSIRT di «valutare la pubblicazione degli advisory in un formato leggibile dalle macchine come il Common Security Advisory Framework (CSAF)», così i clienti possono utilizzarli con i propri strumenti. La guida a CSAF spiega come passare da pagine web e feed RSS a CSAF.
- Informi il supporto prima di pubblicare. Funzione 5.3.4: «Fornire una notifica anticipata e riservata e le FAQ per gli advisory in arrivo prepara coloro a cui potrebbero essere poste domande al momento della pubblicazione.» Il supporto può così rispondere il giorno stesso.
- Invii, non limitarsi a pubblicare. La sotto-funzione 5.4.1.3 osserva che poche visualizzazioni delle pagine degli advisory «possono orientare la Sua strategia verso la notifica proattiva». Feed e notifiche raggiungono clienti che non visitano mai una pagina di advisory.
Il CRA rende in parte tutto questo un obbligo. L'articolo 14(8) impone al fabbricante, dopo essere venuto a conoscenza di una vulnerabilità attivamente sfruttata o di un incidente grave, di informarne gli utilizzatori interessati «e, se del caso, tutti gli utilizzatori», e di farlo «se del caso, in un formato strutturato, leggibile da dispositivo automatico e facilmente trattabile in modo automatico». Il regolamento non indica un formato.
Che cosa automatizzare, in ordine
Ogni passo elimina un tipo di lavoro; la metrica mostra se ci è riuscito.
| Passo | Lavoro che elimina | Metrica che dimostra il risultato |
|---|---|---|
| 1. Un inventario per versione ricavato dalla build | La domanda "che cosa contiene?" all'engineering | Le richieste di indagine all'engineering al mese diminuiscono |
| 2. Confronto continuo delle nuove CVE con ogni versione supportata | Riscansione su richiesta | Tempo dalla pubblicazione della CVE a una decisione coinvolto o non coinvolto |
| 3. Un caso per CVE, con le richieste collegate | Indagini duplicate | Le richieste per caso aumentano, i casi per CVE restano uno |
| 4. Instradamento automatico dei risultati coinvolti al team responsabile (FIRST 2.3.5) | Passaggi manuali | Tempo dalla decisione alla presa in carico da parte di un responsabile |
| 5. Una libreria consultabile delle dichiarazioni VEX e degli advisory pubblicati | Coinvolgimento del PSIRT nelle domande ripetute | Quota di richieste chiuse dal supporto |
| 6. Pubblicazione leggibile dalle macchine (CSAF) | Clienti che chiedono ciò che i loro strumenti avrebbero potuto recuperare | Le richieste per advisory pubblicato diminuiscono |
| 7. Assistenza dell'IA per redigere advisory e risposte | Tempo di scrittura | Tempo dalla decisione all'advisory pubblicato |
L'IA viene per ultima per una ragione. Redige bene sulla base di dati registrati, e non dovrebbe mai essere la fonte della decisione "coinvolto".
Alcune cose non vanno automatizzate: il giudizio "non coinvolto" e la valutazione della gravità restano a una persona, con le prove allegate. L'automazione decide quanto velocemente quella persona riceve le prove.
Metriche che mostrano che il PSIRT sta scalando
- La quota di richieste a cui si risponde senza un caso PSIRT.
- Tempo dalla pubblicazione della CVE a una decisione coinvolto o non coinvolto, per prodotto.
- Richieste di indagine all'engineering al mese. Dovrebbero diminuire.
- Tasso di remediation puntuale per gravità; la sotto-funzione 4.4.2.4 del framework lo definisce come la misura in cui i team di prodotto rispettano il tempo concordato dalla segnalazione alla correzione.
- Copertura VEX e advisory delle versioni che supporta ancora.
Per queste metriche non citiamo benchmark di settore. Nessuna fonte primaria di cui ci fidiamo ne pubblica uno.
Dove si colloca CRACI
CRACI copre i passi 1 e 2, e parte dei passi 4 e 5, per il software compilato in GitHub Actions. Le Sue build vengono eseguite sui runner di CRACI, e CRACI registra ciò che ogni job ha effettivamente scaricato durante l'esecuzione: dipendenze dirette e transitive, pacchetti installati da script e pacchetti ripristinati dalle cache CI. La SBOM di ogni job riporta uno stato di completezza, così un registro parziale non viene mai scambiato per uno completo.
CRACI conserva la cronologia delle build, quindi quando viene pubblicata una nuova CVE vede quali build contenevano la dipendenza vulnerabile, e da quando, fin dove arriva la Sua retention. Le SBOM monitorate vengono rivalutate di continuo, i risultati vengono aggregati tra build e repository, e si possono aggiungere SBOM dei vendor in modo che i componenti acquistati siano monitorati accanto alle Sue build. CRACI notifica alle persone interessate una nuova vulnerabilità e la sua gravità. La vista dell'inventario mostra quali versioni software sono distribuite su quali prodotti, e i team di sicurezza fanno il triage di ogni risultato in CRACI e lo inoltrano al team responsabile della correzione. CRACI supporta VEX. Veda CRACI per i PSIRT e il tracciamento delle vulnerabilità.
Scopra quali delle Sue versioni distribuite contengono una CVE.
Quando CRACI non è la risposta
- Il Suo collo di bottiglia è l'intake e la gestione dei casi, la parte dal CRM al tracker. CRACI non è uno strumento di gestione dei casi né di pubblicazione degli advisory; per quella metà Le serve uno strumento di gestione dei casi (strumenti PSIRT a confronto).
- I Suoi prodotti non vengono compilati in GitHub Actions su runner Linux. GitHub Actions è la CI supportata oggi; GitLab CI e Jenkins sono nella roadmap, senza una data.
- Le serve l'analisi binaria o del firmware di prodotti che non ha compilato Lei. È ciò che fanno gli strumenti di analisi dell'output (strumenti di sicurezza embedded a confronto).
- Le serve l'analisi di raggiungibilità per sostenere "non coinvolto". CRACI non la offre.
Domande frequenti
Come si scala un PSIRT senza assumere?
Smettendo di indagare ripetutamente sulla stessa domanda. Registri che cosa contiene ogni versione distribuita al momento della build, confronti di continuo le nuove CVE con quei dati, decida una volta per CVE e pubblichi la decisione come VEX o come advisory a cui il supporto possa rimandare. Il PSIRT lavora allora sui casi davvero aperti, e all'engineering si chiede di correggere, non di indagare.
Come dovrebbe gestire un PSIRT le richieste "siamo coinvolti?" dei clienti?
Trattandole come un flusso di intake separato dalle segnalazioni di vulnerabilità. Il supporto risponde alle domande sulle CVE già valutate con il materiale pubblicato. Una CVE non ancora valutata riceve un solo caso PSIRT, a cui viene collegata ogni richiesta dei clienti. Solo una nuova vulnerabilità nel Suo codice segue l'intero processo di divulgazione.
Che cosa dice il FIRST PSIRT Services Framework su volume e automazione?
Prevede segnalazioni «attraverso vari canali e di qualità variabile», consente un triage prima della creazione dei casi quando il volume è elevato, definisce un inventario dei componenti di prodotto «essenziale per identificare rapidamente i prodotti interessati» e chiede canali automatizzati che inviino le notifiche di vulnerabilità di terze parti direttamente ai team di sviluppo dei prodotti interessati (funzione 2.3.5).
Che cosa dovrebbe automatizzare per primo un PSIRT?
L'inventario per versione ricavato dalla build, poi il confronto continuo delle nuove CVE con ogni versione supportata. Questi due eliminano la maggior parte del lavoro ripetuto: la domanda "che cosa contiene?" all'engineering e la riscansione su richiesta. Seguono la deduplicazione dei casi, l'instradamento, una libreria consultabile di VEX e advisory e la pubblicazione CSAF.
Come si ottiene che l'engineering risponda in tempo alle domande del PSIRT?
Facendo meno domande all'engineering. Risponda a "il componente è nel prodotto?" con il registro della build, e invii all'engineering solo "potete correggerlo entro questa data?". Concordi un responsabile per prodotto, obiettivi di risposta per gravità per la correzione e un'accettazione formale del rischio quando un obiettivo non viene rispettato.
Perché per un PSIRT conta una SBOM per ogni release?
I clienti usano versioni specifiche, spesso vecchie. Una SBOM del branch predefinito non dice nulla sulla versione X di due anni fa. Una SBOM per ogni versione distribuita, registrata dalla build che l'ha prodotta e conservata per il periodo di supporto, è ciò che consente a un PSIRT di rispondere per ogni versione ancora in campo, compresa la finestra di esposizione.
I clienti vogliono VEX o advisory?
Entrambi, per stati diversi. Il VEX dice agli scanner dei clienti quali CVE non interessano un prodotto, così le segnalazioni cessano. Gli advisory dicono alle persone che cosa è coinvolto, che cosa è corretto e che cosa fare. Pubblicarli entrambi, in formato leggibile dalle macchine dove possibile, risponde alla maggior parte delle domande prima che vengano poste.
