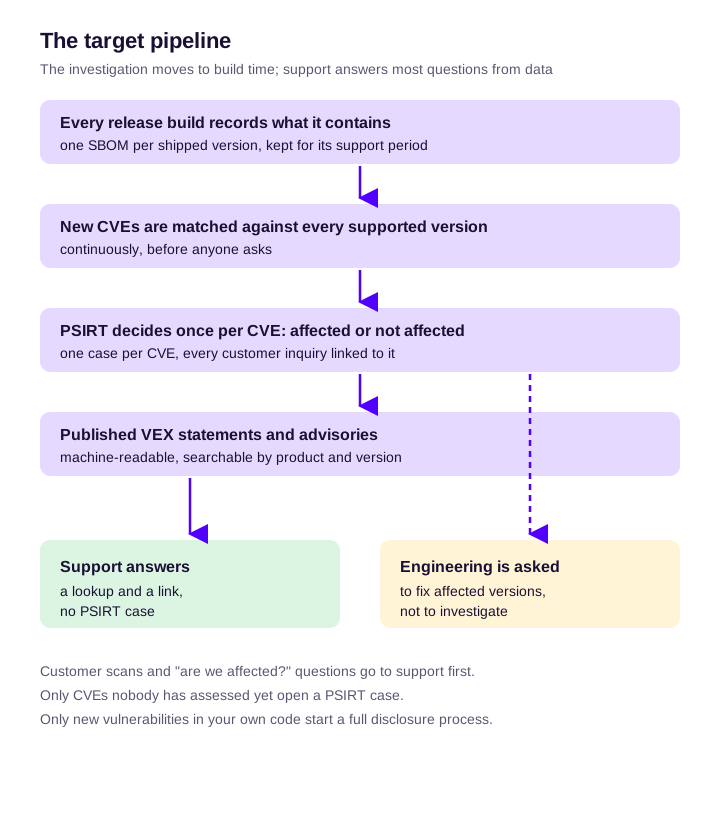
Een stijgend aantal vragen lost u niet op door mensen aan te nemen, en u kunt niet eindeloos sneller triëren. Een PSIRT schaalt door de meeste vragen als "ben ik getroffen?" te beantwoorden met gegevens die zijn vastgelegd toen elke versie werd gebouwd, en door het antwoord te publiceren voordat klanten erom vragen. De dure stap is nu: engineering vragen wat er in een product zit. Verplaats die stap naar het moment van de build, en de meeste vragen worden opzoekacties die support zelf kan afhandelen.
Dit artikel gaat ervan uit dat u al een PSIRT hebt; bent u er een aan het opzetten, begin dan met wat een PSIRT is en hoe u er een opbouwt. Hieronder: waarom het volume is veranderd, waar de tijd heen gaat in de gebruikelijke pipeline, en wat u moet veranderen, op volgorde.
Waarom het volume is veranderd
De toename is structureel, geen slecht kwartaal. Vier ontwikkelingen drukken tegelijk op dezelfde wachtrij.
Meer CVE's. Het CVE-programma publiceerde 39.718 CVE-records in 2024 en 47.801 in 2025. In 2026 was het totaal van heel 2025 al ruim voor het einde van het jaar overschreden; onze live trends in CVE-publicaties volgen het dag voor dag. De update van de kwetsbaarhedenprognose 2026 van FIRST (15 juni 2026) verhoogde de schatting voor het jaar naar ongeveer 66.000 CVE's en noemde de oorzaak zonder omwegen: AI kan aanzienlijk meer fouten vinden dan menselijke analisten, en "de beperking is niet langer het ontdekken; het is de menselijke capaciteit om te verifiëren, te coördineren en te patchen". Een PSIRT is die menselijke capaciteit.
Klanten scannen uw product. Klanten laten scanners los op uw images, firmware en appliances en sturen elke bevinding door als ticket. De meeste van die bevindingen zijn scannerruis over componenten die u niet levert of versies die niet getroffen zijn, en die ruis wordt uw intake. Kwetsbaarheidsruis verminderen behandelt de kant van de scanner.
Regelgeving voegt deadlines toe. Sinds 11 september 2026 gelden de meldplichten van de Europese Cyber Resilience Act. Voor een actief misbruikte kwetsbaarheid in een product dat in de EU wordt verkocht, is binnen 24 uur nadat de fabrikant ervan op de hoogte is geraakt een vroegtijdige waarschuwing nodig.
Minder hulp van de NVD. Op 15 april 2026 stapte NIST voor de National Vulnerability Database over op verrijking op basis van risico: CVE's in de KEV-catalogus van CISA, software die de federale overheid gebruikt en kritieke software volgens EO 14028 gaan voor, en de rest wordt gemarkeerd als "Lowest Priority - not scheduled for immediate enrichment" (laagste prioriteit, niet ingepland voor directe verrijking). Minder CVE's komen binnen met CPE-gegevens, dus matchen op productnaam wordt slechter, net nu het volume stijgt.
| Oorzaak | Wat het doet met de wachtrij van de PSIRT |
|---|---|
| CVE-volume, ontdekking met hulp van AI | Elke maand meer CVE's van derden te beoordelen per product |
| Scans door klanten | Meer vragen per CVE, veel over componenten die u niet levert |
| CRA-meldplicht | Een termijn van 24 uur voor actief misbruikte kwetsbaarheden |
| Minder NVD-verrijking | Meer handwerk om een CVE te koppelen aan de producten die hij raakt |
Waar de tijd heen gaat: de pipeline voor vragen zoals die meestal loopt
We horen steeds weer dezelfde pipeline van productsecurityteams. Een PSIRT van twee personen bij een hardwareleverancier beschreef hem zo: een klant stelt een vraag aan de supportdesk, support stuurt de vraag via het CRM door naar de PSIRT, de case komt in de tracker van de PSIRT terecht, de PSIRT onderzoekt de producten waar klanten het meest naar vragen, en legt de vraag dan bij engineering neer en wacht.
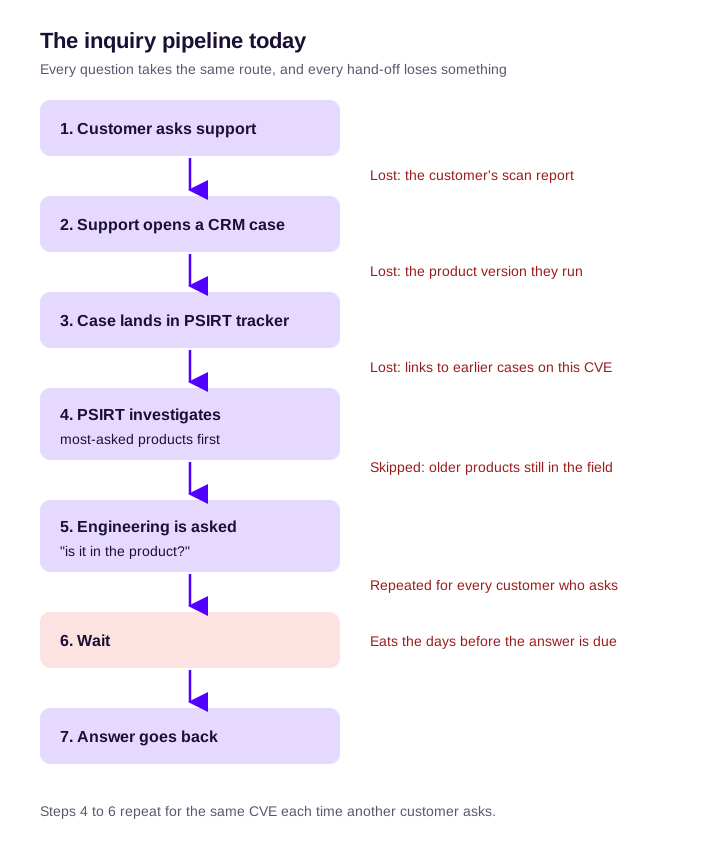
Neem één fictieve vraag als voorbeeld. Een klant stuurt een scannerrapport door dat 40 CVE's vermeldt voor firmwareversie X. Support opent een case en voegt het rapport toe, maar niet de exacte build die de klant draait. De PSIRT kijkt welke van de 40 al beoordeeld zijn, vindt er een stuk of twaalf die dat niet zijn, en vraagt het verantwoordelijke engineeringteam of de componenten in versie X zitten. Engineering moet de broncode van versie X opzoeken, uitzoeken welke versies van afhankelijkheden erin zijn gegaan, en antwoorden. De getallen zijn verzonnen; het patroon niet.
De analyse zelf kost zelden de meeste tijd. Twee verborgen kosten zijn:
- Dezelfde CVE wordt opnieuw onderzocht voor elke klant die ernaar vraagt. Als het antwoord in een e-mailthread staat, begint het onderzoek bij de volgende klant opnieuw.
- "De meest gevraagde producten eerst" laat de lange staart onbeantwoord. Oudere producten die nog in gebruik zijn, worden nooit gecontroleerd, en juist daar zit vaak het risico: oudere componenten, minder updates, minder mensen die nog weten hoe ze zijn gebouwd.
Intake: scheid vragen van meldingen
Een kwetsbaarheidsmelding van een onderzoeker en een "ben ik getroffen?" van een klant zijn verschillend werk, en ze hebben verschillende routes nodig. Het FIRST PSIRT Services Framework rekent al op rommelige input: een PSIRT moet "verwachten kwetsbaarheden via verschillende kanalen en van wisselende kwaliteit te ontvangen" (subfunctie 2.1.1.1). Het servicegebied triage gaat verder: "Waar organisaties een groot aantal kwetsbaarheidsmeldingen ontvangen, kunnen ze overwegen een eerste triage uit te voeren om meldingen te valideren voordat er cases worden aangemaakt." Zie dat als toestemming om niet voor elke vraag een PSIRT-case te openen.
Splits vragen bij de supportdesk in drie routes:
| De klant vraagt naar | Route | Wie antwoordt |
|---|---|---|
| Een gepubliceerde CVE in een component van derden die u al hebt beoordeeld | Antwoord op basis van de gepubliceerde VEX-verklaring of advisory; geen PSIRT-case | Support |
| Een gepubliceerde CVE die u nog niet hebt beoordeeld | Eén PSIRT-case per CVE, niet per klant; koppel elke vraag eraan | PSIRT, daarna antwoordt support iedereen die gekoppeld is |
| Een nieuwe kwetsbaarheid in uw eigen code | Een kwetsbaarheidsmelding: het volledige proces voor gecoördineerde openbaarmaking van kwetsbaarheden | PSIRT |
Support heeft twee dingen nodig om de eerste route te kunnen afhandelen: een doorzoekbare lijst van beoordeelde CVE's per product en versie, en antwoordsjablonen. Hoe u klanten antwoordt na een aanval op de softwareketen bevat sjablonen die u kunt aanpassen.
Leg bij de intake het product vast en de exacte versie die de klant draait. Zonder de versie is elk antwoord "dat hangt ervan af", en komt de case terug.
Prioriteer op blootstelling, niet alleen op populariteit
"De meest gevraagde producten eerst" is een redelijke vuistregel. Er is een tweede as nodig. Houd populariteit aan (installed base, omzet, hoe vaak support ernaar vraagt) en voeg blootstelling toe: wordt het product nog ondersteund, is het in gangbare implementaties vanaf internet bereikbaar, en staat de CVE in de KEV-catalogus van CISA of hoog in EPSS? De gids over prioritering van kwetsbaarheden behandelt de signalen uitgebreid.
| Lage blootstelling | Hoge blootstelling | |
|---|---|---|
| Grote installed base | Antwoord uit de inventaris; publiceer VEX voor niet-getroffen versies | Eerst onderzoeken; advisory en fix met de kortste deadline |
| Kleine installed base | Op verzoek antwoorden uit de inventaris; geen proactief werk | Sla het niet over: antwoord uit de inventaris en beslis dan over een fix of een mitigatiebericht |
Het punt van de matrix zit in de linkerkolom en de onderste rij. De lange staart krijgt een antwoord uit gegevens, niet uit een onderzoek waar niemand tijd voor heeft.
Onder de CRA bepaalt de ondersteuningsperiode die u per product hebt opgegeven voor welke oudere producten u nog antwoorden en beveiligingsupdates verschuldigd bent (wat de CRA vereist).
De overdracht aan engineering is de bottleneck
Deze sectie is voor de engineeringlead die de escalaties van de PSIRT ontvangt.
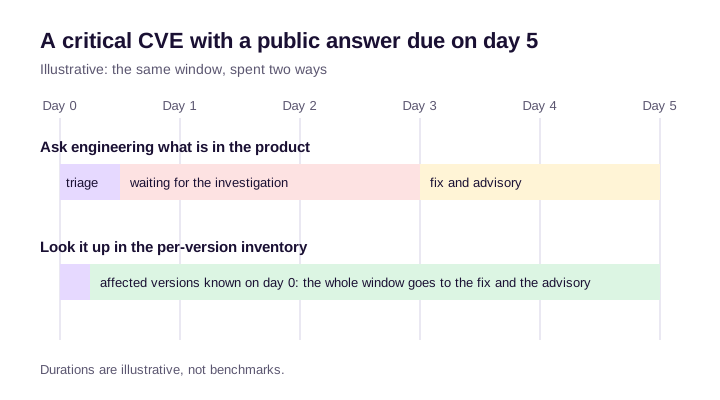
De deadlines van een PSIRT zijn openbaar: een klant, een toezichthouder of een openbaarmakingsdatum wacht. De deadlines van engineering zijn dat meestal niet, dus de PSIRT vangt het verschil op. Een kritiek probleem dat op maandag wordt overgedragen en op dinsdag nog geen antwoord heeft, laat twee dagen over voordat het openbare antwoord moet verschijnen.
De PSIRT stelt engineering twee verschillende vragen, en maar één ervan zou engineering nodig moeten hebben:
- "Zit het component in het product?" is een gegevensvraag. Die moet worden beantwoord uit een vastlegging, niet door iemand die buildbestanden doorleest.
- "Kunt u het vóór datum X oplossen?" is een werkvraag. Die hoort bij engineering.
Het FIRST-framework zegt hoe u de eerste vraag van het bureau van engineering haalt. Functie 2.3.5 vraagt PSIRT's om "geautomatiseerde kanalen op te zetten die geïdentificeerde meldingen over kwetsbaarheden van derden rechtstreeks naar de ontwikkelteams van getroffen producten sturen", zodat advisories van derden in het ontwikkelproces worden verwerkt en de PSIRT er minder met de hand afhandelt.
Spreek drie dingen af met engineering:
- Een eigenaar per product. Bij grote leveranciers is herstel verspreid over productteams; het gedistribueerde model van het framework bestaat omdat de missie van de PSIRT daarmee kan schalen via de engineers die de producten beheren.
- Responsdoelen per ernst, op papier, voor de fix in plaats van voor het onderzoek.
- Wat er gebeurt als een doel wordt gemist. Functie 4.2.4 vraagt om "een proces voor formele risicoacceptatie voor alle kwetsbaarheden die niet binnen de termijnen van de interne SLA's zijn verholpen". Iemand met bevoegdheid tekent voor het risico; het blijft niet gewoon openstaan.
Het tempo van fixes verschilt. Het ene team levert binnen een nacht een patch, een ander heeft een platformupgrade van zes maanden nodig. De advisory moet zeggen welke van de twee, zodat klanten kunnen plannen.
Maak van "zijn wij getroffen?" een opzoekactie: een SBOM voor elke geleverde versie
Dit is de verandering die het meeste werk wegneemt. FIRST-functie 2.3.1, de inventaris van productcomponenten, noemt die "essentieel om snel getroffen producten te identificeren bij overgeërfde kwetsbaarheden". De PSIRT-volwassenheidsniveaus plaatsen een productregister met mapping van afhankelijkheden op het gemiddelde niveau en monitoring van kwetsbaarheden in productcomponenten op het gevorderde niveau.
Een inventaris neemt alleen werk weg als hij standhoudt onder volume. Elke eis hieronder heeft een reden:
- Eén SBOM per geleverde versie, niet per repository en niet van de standaardbranch. Klanten draaien versies, geen branches.
- Vastgelegd tijdens de build die de release opleverde. Een latere herbouw, of een scan van de repository van vandaag, beschrijft andere software (SBOM's tijdens de build).
- Inclusief transitieve en verborgen afhankelijkheden. Het kwetsbare pakket is zelden een pakket dat u zelf hebt toegevoegd (transitieve afhankelijkheden), en installatiescripts, base images en herstelde caches halen componenten binnen die in geen enkel lockfile staan.
- Een signaal over volledigheid. Een gedeeltelijke vastlegging die als volledig wordt behandeld, levert stellige "niet getroffen"-antwoorden op die onjuist zijn.
- Bewaard zolang de versie wordt ondersteund. De vastlegging van een versie van drie jaar geleden is precies degene die u nodig hebt als niemand meer weet hoe die is gebouwd.
- SBOM's van leveranciers voor ingekochte componenten, zodat software van derden in dezelfde inventaris staat als uw eigen software.
- Doorlopend opnieuw gematcht wanneer nieuwe CVE's verschijnen, in plaats van opnieuw gescand wanneer iemand erom vraagt.
Een uitgewerkt voorbeeld. Er verschijnt een nieuwe CVE in een veelgebruikte compressiebibliotheek. Zonder de inventaris vraagt de PSIRT elk productteam, druppelen de antwoorden in de loop van dagen binnen, en worden de oudste producten nooit gecontroleerd. Met de inventaris levert één zoekopdracht de getroffen producten en versies op, plus de eerste en laatste builds die de kwetsbare versie bevatten. Dat is het blootstellingsvenster waar klanten daarna naar vragen; zijn wij getroffen door een CVE? laat zien hoe u dat voor één geval vaststelt.
Embedded- en Yocto-portfolio's hebben het het zwaarst. Scanners die een afgewerkt firmware-image lezen, moeten raden wat erin is gecompileerd, en teams die we spreken hebben scanner-proofs-of-concept zien mislukken op producten op basis van Yocto. Wie de build vastlegt terwijl die draait, hoeft niet te raden (Yocto-builds op CRACI).
Vraagt een klant daarna om de SBOM zelf, in een bepaald formaat, zie dan SBOM-verzoeken van klanten beantwoorden.
De uitvoerkant: advisories en VEX die antwoorden voordat iemand het vraagt
De goedkoopste vraag is de vraag die nooit binnenkomt.
- Publiceer "niet getroffen" als VEX, zodat de scanners van klanten de CVE niet meer markeren, en publiceer "getroffen" en "opgelost" als advisories met exacte versies.
- Maak het machineleesbaar. FIRST-subfunctie 5.3.2.3 stelt voor dat PSIRT's "overwegen advisories te publiceren in een machineleesbaar formaat zoals het Common Security Advisory Framework (CSAF)", zodat klanten ze met hun eigen tools kunnen verwerken. De CSAF-gids beschrijft hoe u van webpagina's en RSS-feeds overstapt op CSAF.
- Informeer support vóór u publiceert. Functie 5.3.4: "Een vroegtijdige, vertrouwelijke kennisgeving en FAQ voor komende advisories bereidt degenen voor die er bij publicatie vragen over kunnen krijgen." Support kan dan op de dag zelf antwoorden.
- Stuur actief, plaats niet alleen. Subfunctie 5.4.1.3 merkt op dat weinig paginaweergaven op advisories "uw strategie in de richting van proactieve kennisgeving kunnen sturen". Feeds en notificaties bereiken klanten die nooit een advisorypagina bezoeken.
De CRA maakt een deel hiervan tot een plicht. Artikel 14(8) verplicht de fabrikant om, nadat hij op de hoogte is geraakt van een actief misbruikte kwetsbaarheid of een ernstig incident, de getroffen gebruikers "en, waar passend, alle gebruikers" te informeren, en dat te doen "waar passend in een gestructureerd, machineleesbaar formaat dat gemakkelijk automatisch kan worden verwerkt". De verordening noemt geen formaat.
Wat u automatiseert, op volgorde
Elke stap neemt een soort werk weg; de metriek laat zien of dat gelukt is.
| Stap | Werk dat verdwijnt | Metriek die laat zien dat het werkt |
|---|---|---|
| 1. Een inventaris per versie uit de build | De vraag "wat zit erin?" aan engineering | Het aantal onderzoeksverzoeken aan engineering per maand daalt |
| 2. Doorlopend matchen van nieuwe CVE's met elke ondersteunde versie | Opnieuw scannen op verzoek | Tijd van CVE-publicatie tot een besluit over getroffen of niet getroffen |
| 3. Eén case per CVE, met de vragen eraan gekoppeld | Dubbele onderzoeken | Vragen per case stijgen, cases per CVE blijven op één |
| 4. Automatisch doorsturen van getroffen bevindingen naar het verantwoordelijke team (FIRST 2.3.5) | Handmatige overdrachten | Tijd van besluit tot bevestiging door een eigenaar |
| 5. Een doorzoekbare bibliotheek van gepubliceerde VEX-verklaringen en advisories | Betrokkenheid van de PSIRT bij herhaalde vragen | Aandeel vragen dat door support wordt afgehandeld |
| 6. Machineleesbaar publiceren (CSAF) | Klanten die vragen om wat hun tools hadden kunnen ophalen | Vragen per gepubliceerde advisory dalen |
| 7. AI-ondersteuning bij het opstellen van advisories en antwoorden | Schrijftijd | Tijd van besluit tot gepubliceerde advisory |
AI komt niet voor niets als laatste. Het schrijft goede concepten op basis van vastgelegde gegevens, en het mag nooit de bron zijn van het besluit "getroffen".
Sommige dingen moet u niet automatiseren: het oordeel "niet getroffen" en de inschatting van de ernst blijven bij een mens, met het bewijs erbij. Automatisering bepaalt hoe snel die persoon het bewijs krijgt.
Metrieken die laten zien dat de PSIRT schaalt
- Het aandeel vragen dat zonder PSIRT-case wordt beantwoord.
- De tijd van CVE-publicatie tot een besluit over getroffen of niet getroffen, per product.
- Het aantal onderzoeksverzoeken aan engineering per maand. Dat hoort te dalen.
- Het percentage tijdig herstel per ernst; subfunctie 4.4.2.4 van het framework definieert dat als hoe goed productteams de afgesproken tijd van melding tot fix halen.
- De dekking met VEX en advisories van de versies die u nog ondersteunt.
We noemen hiervoor geen branchebenchmarks. Geen primaire bron die we vertrouwen publiceert er een.
Waar CRACI past
CRACI dekt stap 1 en 2, en een deel van stap 4 en 5, voor software die in GitHub Actions wordt gebouwd. Uw builds draaien op de runners van CRACI, en CRACI legt tijdens de uitvoering vast wat elke job werkelijk binnenhaalde: directe en transitieve afhankelijkheden, pakketten die door scripts zijn geïnstalleerd en pakketten die uit CI-caches zijn hersteld. De SBOM van elke job heeft een volledigheidsstatus, zodat een gedeeltelijke vastlegging nooit voor een volledige wordt aangezien.
CRACI bewaart de buildgeschiedenis, dus wanneer een nieuwe CVE verschijnt, ziet u welke builds de kwetsbare afhankelijkheid bevatten, en sinds wanneer, zo ver terug als uw bewaartermijn reikt. Gemonitorde SBOM's worden doorlopend opnieuw beoordeeld, bevindingen worden over builds en repositories heen samengevoegd, en SBOM's van leveranciers kunnen worden toegevoegd, zodat ingekochte componenten naast uw eigen builds worden gemonitord. CRACI brengt de betrokken mensen op de hoogte van een nieuwe kwetsbaarheid en de ernst ervan. De inventarisweergave toont welke softwareversies op welke producten zijn uitgerold, en securityteams triëren elke bevinding in CRACI en sturen die naar het team dat verantwoordelijk is voor de fix. CRACI ondersteunt VEX. Zie CRACI voor PSIRT's en het volgen van kwetsbaarheden.
Zie welke van uw geleverde versies een CVE bevatten.
Wanneer CRACI niet het antwoord is
- Uw bottleneck is de intake en het casebeheer, het deel van CRM naar tracker. CRACI is geen tool voor casebeheer of het publiceren van advisories; voor die helft hebt u een casetool nodig (PSIRT-tools vergeleken).
- Uw producten worden niet in GitHub Actions op Linux-runners gebouwd. GitHub Actions is vandaag de ondersteunde CI; GitLab CI en Jenkins staan op de roadmap, zonder datum.
- U hebt binaire analyse of firmwareanalyse nodig van producten die u niet zelf hebt gebouwd. Dat doen tools die de output analyseren (embedded-securitytools vergeleken).
- U hebt reachability-analyse nodig om "niet getroffen" te onderbouwen. CRACI biedt dat niet.
Veelgestelde vragen
Hoe schaalt u een PSIRT op zonder mensen aan te nemen?
Stop met het steeds opnieuw onderzoeken van dezelfde vraag. Leg tijdens de build vast wat elke geleverde versie bevat, match nieuwe CVE's daar doorlopend mee, beslis één keer per CVE, en publiceer het besluit als VEX of als advisory waarnaar support kan verwijzen. De PSIRT werkt dan aan de cases die echt open zijn, en engineering wordt gevraagd te fixen, niet te onderzoeken.
Hoe moet een PSIRT omgaan met vragen van klanten als "zijn wij getroffen?"?
Behandel ze als een aparte intakestroom, los van kwetsbaarheidsmeldingen. Support beantwoordt vragen over CVE's die u al hebt beoordeeld op basis van gepubliceerd materiaal. Een CVE die u nog niet hebt beoordeeld, krijgt één PSIRT-case, met elke klantvraag eraan gekoppeld. Alleen een nieuwe kwetsbaarheid in uw eigen code doorloopt het volledige openbaarmakingsproces.
Wat zegt het FIRST PSIRT Services Framework over volume en automatisering?
Het rekent op meldingen "via verschillende kanalen en van wisselende kwaliteit", staat triage toe voordat er cases worden aangemaakt als het volume hoog is, noemt een inventaris van productcomponenten "essentieel om snel getroffen producten te identificeren", en vraagt om geautomatiseerde kanalen die meldingen over kwetsbaarheden van derden rechtstreeks naar de ontwikkelteams van getroffen producten sturen (functie 2.3.5).
Wat moet een PSIRT als eerste automatiseren?
De inventaris per versie, vastgelegd uit de build, en daarna het doorlopend matchen van nieuwe CVE's met elke ondersteunde versie. Die twee nemen het meeste herhaalde werk weg: de vraag "wat zit erin?" aan engineering en het opnieuw scannen op verzoek. Ontdubbelen van cases, doorsturen, een doorzoekbare bibliotheek van VEX en advisories, en publiceren in CSAF komen daarna.
Hoe zorgt u dat engineering vragen van de PSIRT op tijd beantwoordt?
Stel engineering minder vragen. Beantwoord "zit het component in het product?" uit de buildvastlegging, en stuur engineering alleen "kunt u het vóór deze datum oplossen?". Spreek een eigenaar per product af, responsdoelen per ernst voor de fix, en een formele risicoacceptatie als een doel wordt gemist.
Waarom is een SBOM per release belangrijk voor een PSIRT?
Klanten draaien specifieke versies, vaak oude. Een SBOM van de standaardbranch zegt niets over versie X van twee jaar geleden. Eén SBOM per geleverde versie, vastgelegd uit de build die hem opleverde en bewaard gedurende de ondersteuningsperiode, maakt het mogelijk dat een PSIRT antwoord geeft voor elke versie die nog in gebruik is, inclusief het blootstellingsvenster.
Willen klanten VEX of advisories?
Allebei, voor verschillende statussen. VEX vertelt de scanners van klanten welke CVE's een product niet raken, zodat de bevindingen stoppen. Advisories vertellen mensen wat getroffen is, wat is opgelost en wat ze moeten doen. Wie beide publiceert, waar mogelijk machineleesbaar, beantwoordt de meeste vragen voordat ze worden gesteld.
